Le modèle n’écrit que ce que des règles ne savent pas écrire. Le trajet complet d’une offre jusqu’au CV rendu, le calcul du score ATS et la façon dont les coûts IA restent sous contrôle.
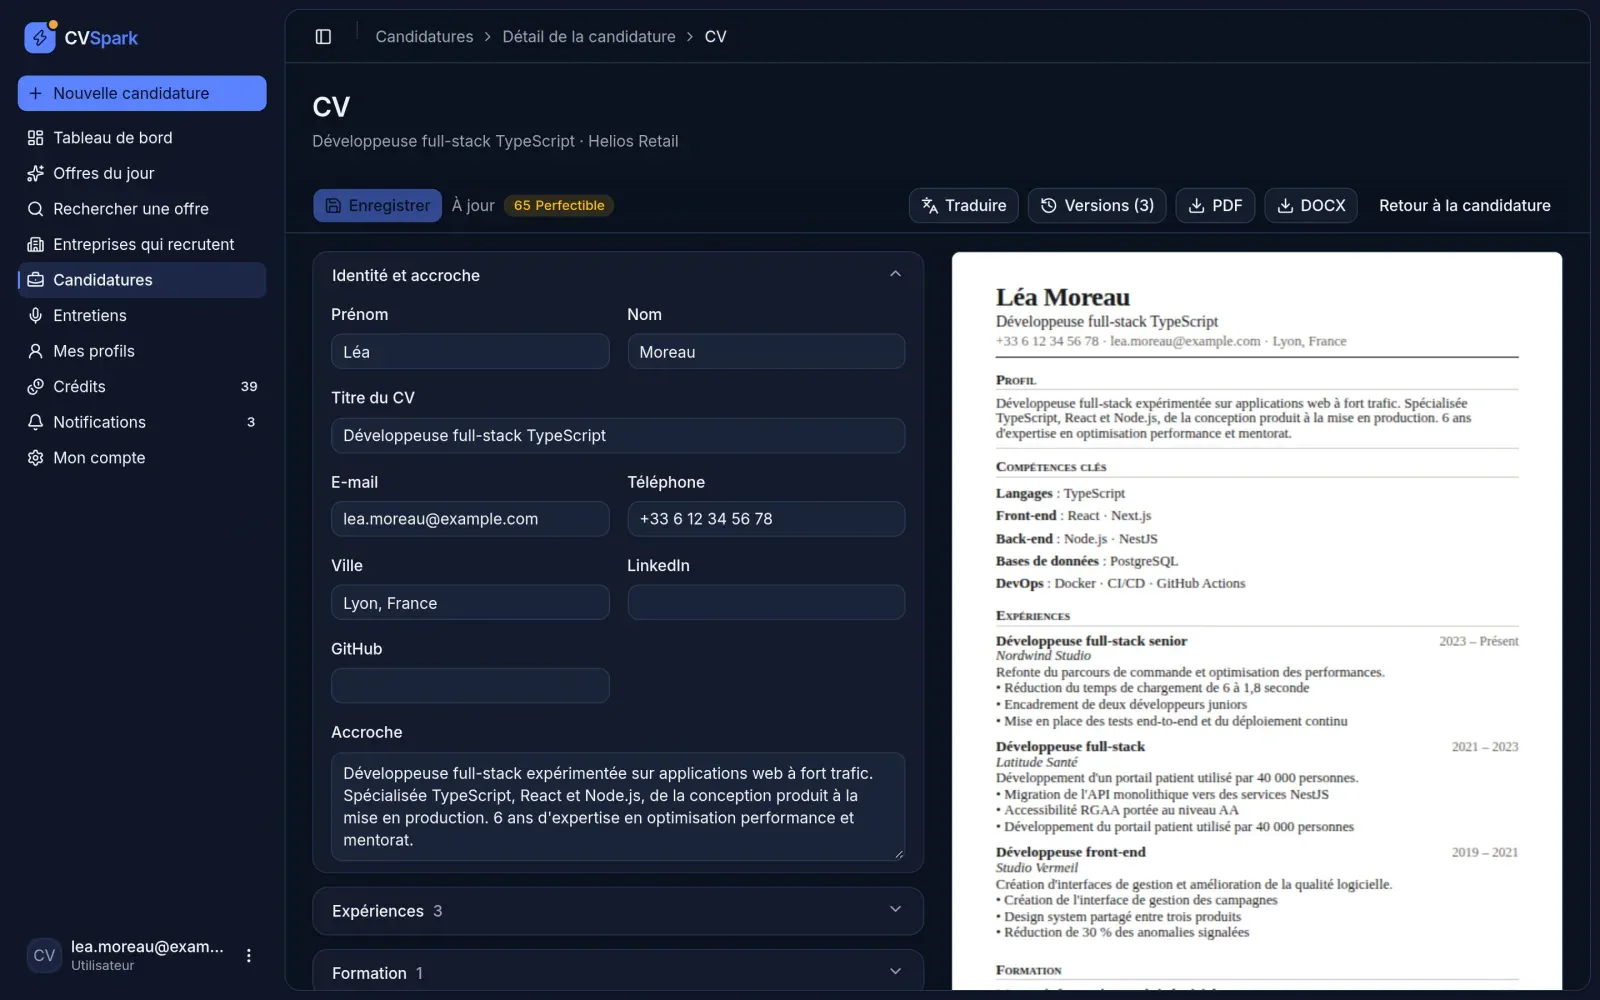
Jobspark promet un CV adapté à chaque offre et un score ATS pour savoir s’il passera les filtres. Dit comme ça, on imagine un gros prompt qui fait tout. C’est l’inverse : le modèle n’écrit que ce qu’on ne sait pas écrire avec des règles, et tout le reste est du code ordinaire, testable et gratuit à exécuter. Voici le trajet complet, extraits du repo à l’appui.
D’une offre à une candidature structurée
Tout part d’une offre : une URL, un texte collé ou une offre du jour. L’API en extrait le texte visible, puis fait un premier appel au modèle, à température 0, pour la structurer : intitulé, entreprise, lieu, contrat, missions, exigences, et surtout 8 à 20 mots-clés copiés dans les mots exacts de l’offre. La consigne interdit les verbes, les qualités génériques et les noms de produits de l’employeur.
Ces mots-clés servent deux fois : ils guident la rédaction du CV, puis ils servent de référence au score ATS. Cette étape coûte 1 crédit. Si la structuration échoue, la candidature est quand même créée à partir du texte brut : la première ligne devient l’intitulé.
Un prompt en trois blocs, et un profil sans nom
Le premier risque d’un générateur de CV, c’est la contamination : le modèle lit une stack dans l’offre et l’attribue au candidat. Le message envoyé au modèle sépare donc nettement ce que veut l’employeur de ce que le candidat a réellement fait. L’offre vient en premier, le profil en dernier, pour que la source de vérité soit la plus proche de la génération.
return [
  "=== OFFRE D'EMPLOI — CONTEXTE DE CIBLAGE ===",
  "Ce bloc décrit ce que L'EMPLOYEUR recherche. Rien ici n'est un fait concernant le candidat.",
  JSON.stringify(offerFields),
  "=== FIN OFFRE D'EMPLOI ===",
  "=== TEXTE BRUT DE L'OFFRE — NON FIABLE ===",
  "Extrait web non vérifié. Ne recopie jamais son contenu comme une compétence ou une expérience du candidat.",
  rawOfferText.slice(0, MAX_RAW_OFFER_CHARS),
  "=== FIN TEXTE BRUT ===",
  // … PISTES À VALORISER, VOCABULAIRE DE L'OFFRE (si présents)
  "=== PROFIL CANDIDAT — SOURCE DE VÉRITÉ ===",
  "Seuls les faits de ce bloc peuvent figurer dans le document.",
  JSON.stringify({ headline, identity, profileSections }),
  "--- INVENTAIRE AUTORISÉ (rien en dehors de ces listes) ---",
  JSON.stringify(inventory(profile)),
  "=== FIN PROFIL CANDIDAT ===",
  "Rappel final : tout élément du bloc OFFRE absent du bloc PROFIL CANDIDAT est interdit dans ta réponse.",
].join("\n");
Le profil envoyé est pseudonymisé dès l’app web : le prénom et la ville partent, le nom devient [CANDIDATE], et l’e-mail, le téléphone et les liens restent dans des « champs locaux » que le serveur réinjecte après coup. L’« inventaire autorisé » liste les seules compétences, entreprises, écoles, certifications et langues que le modèle a le droit de citer.
Le prompt système du CV fait une centaine de lignes. Il commence par une règle prioritaire : aucun chiffre, outil ou diplôme absent du profil. Il précise aussi des détails qui comptent pour un ATS : une puce commence par une action, un chiffre présent dans le profil ne doit pas se perdre, une compétence listée doit être étayée ailleurs dans le CV.
Le trajet d’une génération
L’ordre des étapes est voulu. Un profil sans expérience ni compétence est refusé avant tout appel : sans matière, le modèle ne peut qu’inventer. Le solde est vérifié avant l’appel, mais le débit n’a lieu qu’une fois la sortie analysée, normalisée et recalée. Une réponse inexploitable ne coûte rien au candidat.
Ce que le serveur vérifie après le modèle
Le prompt demande de ne rien inventer, mais je ne lui fais pas confiance. Après l’appel, groundCvContent recale le CV sur le profil. La liste des expériences est reconstruite depuis la source, et l’entreprise, le poste et les dates sont réécrits. Une compétence, une langue, un projet ou une certification que le profil n’étaye pas est retiré. Le niveau de langue est toujours celui du profil. Pour les chiffres, la règle est stricte :
/**
 * Drops any bullet carrying a figure the source does not state. Stripping the
 * figure instead would leave an unsourced performance claim behind.
 */
function guardAchievements(generated, source, removals) {
  const allowed = new Set([
    ...extractNumbers(source.results),
    ...extractNumbers(source.period),
  ]);

  const kept = (generated?.achievements ?? []).filter((achievement) => {
    const unsourced = extractNumbers(achievement).some(
      (number) => !allowed.has(number),
    );
    if (unsourced) {
      removals.push({ context: source.company, kind: "achievement", label: achievement });
    }
    return !unsourced;
  });

  return kept.length > 0 ? kept : fallbackAchievements(source.results);
}
On ne retire pas seulement le chiffre : on supprime toute la puce. Un « réduit de 40 % » dont on a enlevé le 40 % reste une affirmation de performance que personne n’a faite. Chaque suppression est consignée dans le document, avec son contexte.
Le rendu : un HTML pensé pour être relu par une machine
Le package document-renderer transforme le CV structuré en HTML. Le même code sert à l’aperçu de l’éditeur et à l’export, et un conteneur Puppeteer l’imprime en PDF. Un détail montre bien la difficulté : les puces sont écrites dans le texte, et non laissées à list-style. Un marqueur CSS est bien dessiné dans le PDF, mais il n’arrive pas dans sa couche texte. Notre propre CV ressortait alors avec « expériences non détaillées en puces ». L’export DOCX existe aussi, généré à part.
Comment le score ATS est calculé
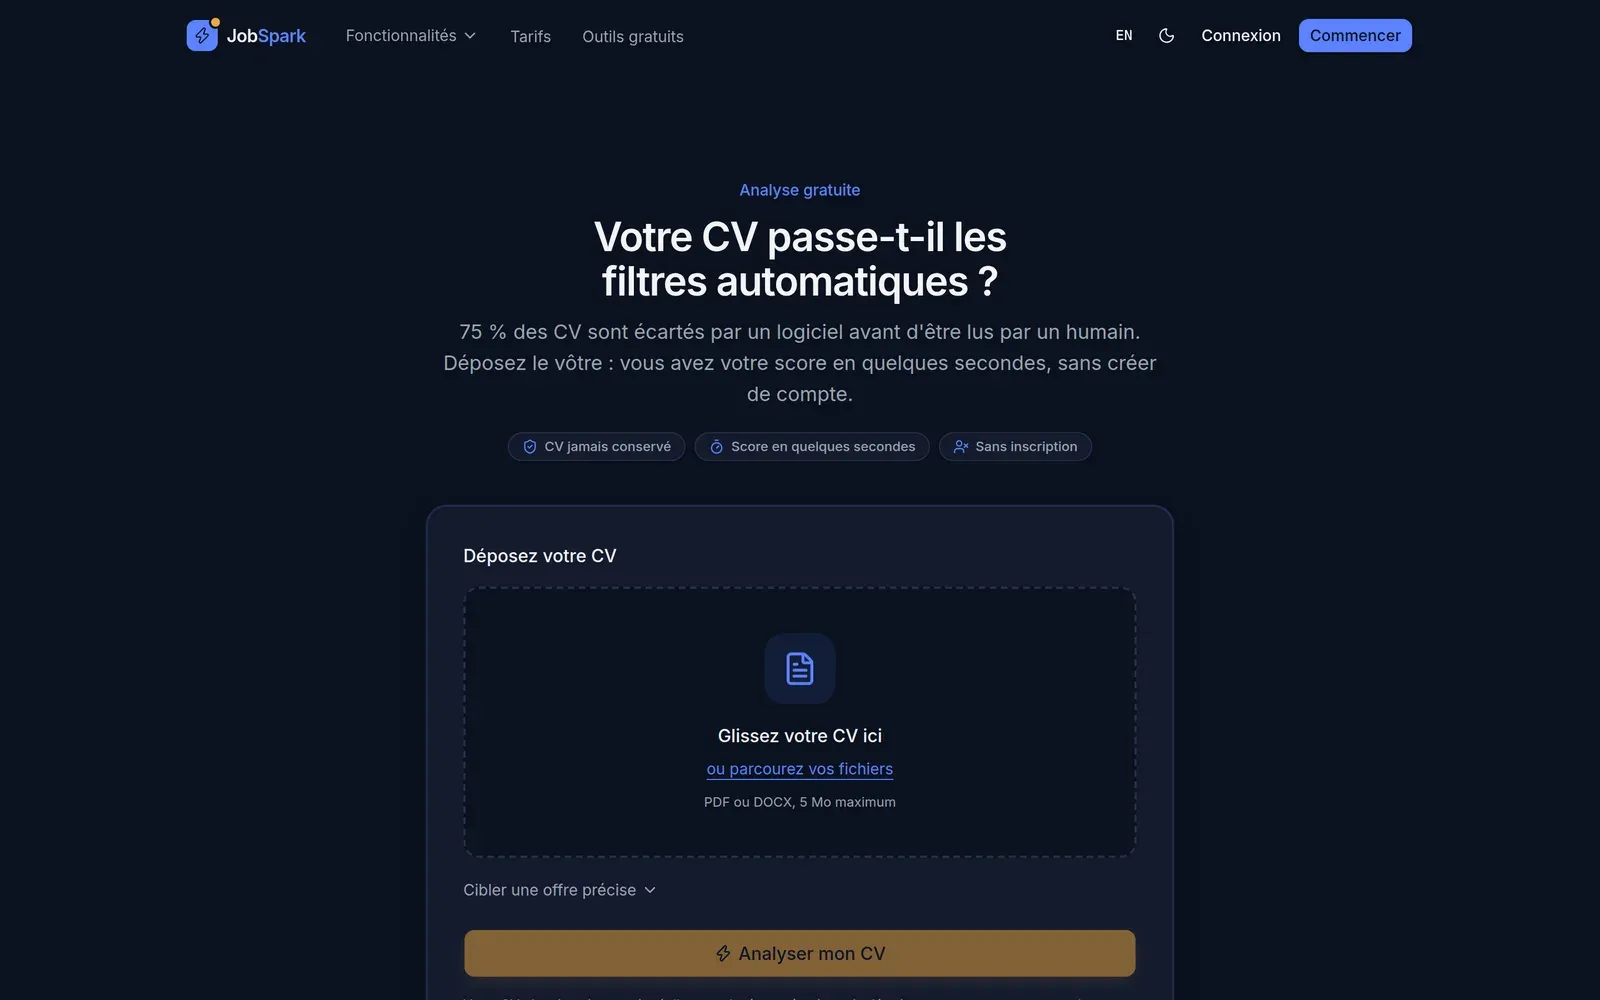
Le score vit dans un package TypeScript pur, packages/ats-score, sans dépendance à Nest, à une base ou à une variable d’environnement. Il sert deux surfaces très différentes : la landing, qui reçoit un PDF inconnu sans offre, et l’app, qui a un CV structuré et l’offre liée. Deux adaptateurs ramènent les deux entrées au même AtsDocument. Un test vérifie qu’un même CV passé par les deux chemins obtient un score à 3 points près.
Six dimensions pèsent sur 100 : lisibilité machine, structure, mots-clés et impact à 20 chacune, contacts et forme à 10. Une dimension qu’on ne peut pas observer est exclue, jamais notée zéro. Sans offre, les mots-clés sortent du calcul et les poids sont renormalisés sur ce qui reste. Dans l’app, la lisibilité machine est exclue tant qu’aucun fichier n’existe, puisque c’est nous qui produisons le PDF.
export const ATS_DIMENSION_WEIGHTS: Record<AtsDimensionKey, number> = {
  machineReadability: 20,
  structure: 20,
  keywords: 20,
  impact: 20,
  contactability: 10,
  formatHygiene: 10,
};

export const CRITICAL_CAPS: Partial<Record<AtsFindingCode, number>> = {
  TOO_SHORT: 45,                  // Nothing to index
  MISSING_EXPERIENCE_SECTION: 50, // No career to read
  MULTI_COLUMN_LAYOUT: 55,        // The parser interleaves the columns
  MISSING_EMAIL: 65,              // A recruiter who wants to answer cannot
  UNPARSABLE_DATES: 70,
  LOW_KEYWORD_COVERAGE: 70,
  MISSING_SKILLS_SECTION: 75,
  MISSING_QUANTIFICATION: 80,     // Duties without results
};
Les plafonds sont venus d’un test en navigateur. Un CV squelettique de 35 mots obtenait 61/100 : la longueur ne pesait que sur une dimension à 10 points, et le défaut se noyait dans la moyenne. Désormais, un constat critique plafonne le total, et le plafond le plus bas l’emporte. Le résultat expose cappedBy, parce qu’un score plafonné sans explication ressemble à une jauge cassée.
Pour les mots-clés, le score mesure la part des mots-clés de l’offre présents dans le CV, accents et pluriels neutralisés. La note maximale est atteinte à 60 % de couverture, parce qu’un CV qui reprend tous les termes est un CV écrit pour un parseur. Au-delà de six répétitions d’un même terme, le moteur signale un bourrage de mots-clés.
Pour vérifier, j’ai lancé le vrai moteur compilé sur un CV fictif, avec une offre React de sept mots-clés :
Sans offre, le CV est jugé sur quatre dimensions. Avec l’offre, il couvre 4 mots-clés sur 7, soit 57 %, presque le plafond de 60 % : d’où 95. Les trois manquants sont listés pour que le candidat ajoute ceux qu’il pratique vraiment. Si on retire l’e-mail, rien d’autre ne bouge, mais le score tombe à 65 et cappedBy dit pourquoi.
La place exacte du modèle
Le modèle n’intervient que sur la dimension « impact », et seulement sur l’analyse publique de la landing. Il rend quatre sous-notes sur 10 : verbes d’action, quantification, pertinence et cohérence. Il ne rend jamais le score lui-même.
export const LLM_INFLUENCE = 25;

export function scoreImpact(doc: AtsDocument, llm?: AtsLlmSignals | null) {
  const rules = scoreImpactByRules(doc);

  if (!llm) {
    return { ...rules, applied: false };
  }

  const blended = clamp(
    llmScore(llm),
    rules.score - LLM_INFLUENCE,
    rules.score + LLM_INFLUENCE,
  );

  return { ...rules, applied: true, score: toScore(blended) };
}
Le score par règles est toujours calculé, et le modèle ne peut le déplacer que de 25 points. L’appel se fait à température 0, avec un schéma de réponse imposé et un texte re-pseudonymisé juste avant l’envoi. S’il échoue, le score tombe en mode règles. Dans l’app, le score d’un CV généré n’appelle aucun modèle : il est recalculé gratuitement à chaque enregistrement. Le barème est versionné (1.3.0 aujourd’hui) et stocké avec chaque score, pour ne jamais comparer deux mesures faites avec des règles différentes.
Garder les coûts IA sous contrôle
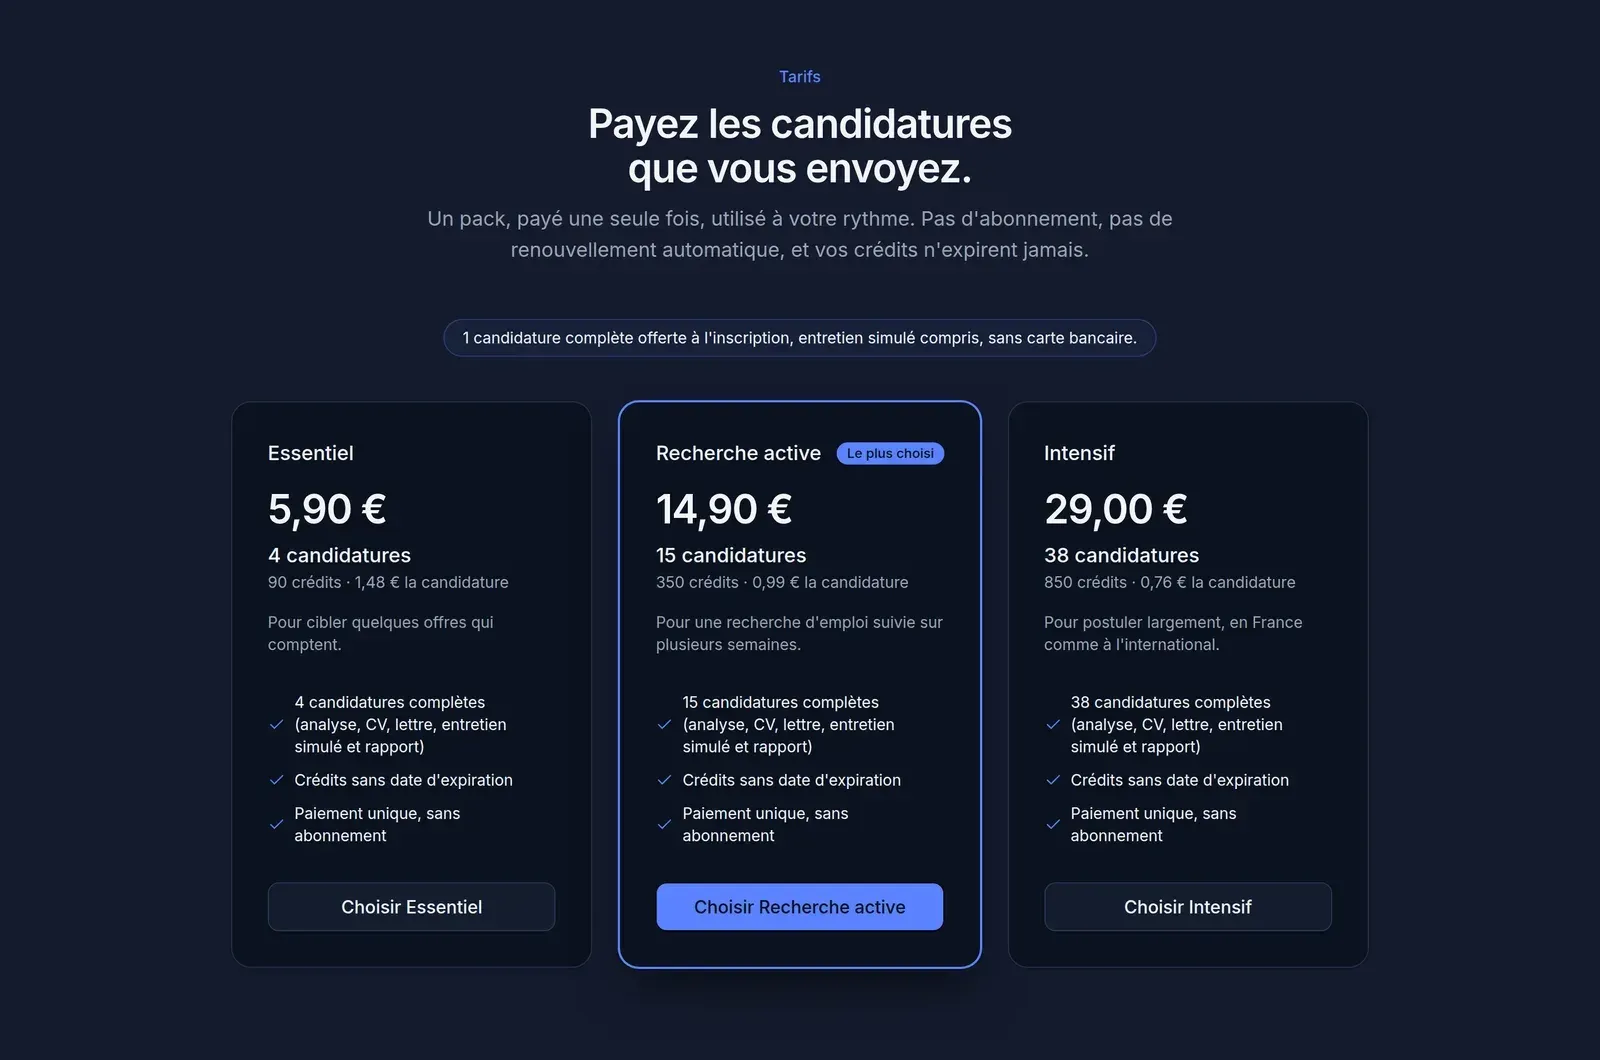
Chaque action payante a un prix fixe en crédits, défini à un seul endroit dans @cvforge/types : 1 pour l’analyse d’une offre, 3 pour un CV, 3 pour une lettre, 3 pour une traduction, 2 pour l’import d’un CV. L’entretien se paie à la minute (1,5 crédit, arrondi au crédit supérieur), parce qu’une séance de trente minutes coûte vraiment trois fois plus qu’une séance de dix. Les packs sont affichés en nombre de candidatures plutôt qu’en crédits.
Le choix du modèle se fait sur mesure, pas sur réputation. Le modèle par défaut est Mistral Small 3.2 via OpenRouter, servi par plusieurs fournisseurs. Les modèles de secours sont classés selon leur fidélité au profil, mesurée sur un cas piège :
const DEFAULT_MODEL = "mistralai/mistral-small-3.2-24b-instruct";

/**
 * Ordered by grounding fidelity, measured on a CV whose target offer demanded
 * skills the profile did not hold: gpt-4.1-nano drifted on 0 summaries out of
 * 4, gemini-2.5-flash on 1. [...]
 * deepseek-v4-flash is deliberately absent despite being the cheapest of all:
 * it drifted on 4 summaries out of 4 [...]
 */
const DEFAULT_FALLBACK_MODELS = [
  "openai/gpt-4.1-nano",
  "google/gemini-2.5-flash",
];
Le modèle le moins cher a été écarté parce qu’il reformulait les thèmes de l’offre comme s’il s’agissait de l’expérience du candidat. Un contrôle lexical ne voit pas ce genre de dérive. L’API parcourt elle-même la chaîne : elle réessaie une erreur passagère, passe au modèle suivant si le premier est indisponible, et s’arrête net sur une requête invalide.
- Chaque appel est enregistré par fonctionnalité, avec le modèle, les tokens, le coût réel facturé par OpenRouter et un indicateur de bascule.
- Le solde du compte OpenRouter est lu via son API et gardé en cache 5 minutes. Sous le seuil critique, la vente de crédits est refusée : on ne vend pas ce qu’on ne peut pas servir.
- L’analyse ATS publique est limitée par IP et par un budget global quotidien de 300 analyses, vérifié avant tout parsing ou appel.
Ce que je retiens
La qualité ne vient pas du prompt seul. Elle vient de ce qui l’entoure : des entrées séparées et pseudonymisées, une sortie recalée sur le profil, un score déterministe et versionné, et un modèle qui affine sans jamais décider. C’est aussi ce qui garde les coûts lisibles : le modèle n’est appelé que là où il apporte quelque chose, et le candidat ne paie que ce qui a réellement abouti.
#ats#llm#openrouter#prompt-engineering#nestjs#typescript#couts-ia#jobspark