Toute ma plateforme d’hébergement décrite en code : une app = un fichier YAML.
- Rôle
- Architecte et opérateur
- Période
- 2026
- Contexte
- Héberge Jobspark, Jémima et ce site
1
fichier par app
2
environnements par app
35 j
de rétention en production
0
plan destructeur accepté
Contexte
Des stacks docker-compose déployées à la main, des volumes au nommage hétérogène, des sauvegardes inégales selon les projets.
Le défi
Standardiser sans rien casser de ce qui tourne en production, et rendre chaque serveur reconstructible depuis le repo.
- 01Infra
Un manifest par app
Schéma JSON versionné : apps, workers, bases, caches, environnements, domaines. Un module Terraform le traduit en ressources Dokploy, un service par composant.
- 02Ops
Données protégées par défaut
Sauvegarde quotidienne de chaque base et volume vers R2. Le déploiement refuse tout plan qui détruit une ressource avec état ; supprimer un environnement archive d’abord ses volumes.
- 03Ops
Adoption sans recréer
Un Dokploy déjà en production se reprend par import Terraform : Jobspark et Jémima ont migré sans interruption.
- 04Infra
Multi-serveurs
Ajouter une machine = un playbook Ansible + une ligne dans nodes.yaml. Purge automatique des images et du cache de build.
Architecture
Stack
- DDokploy
- Terraform / OpenTofu
- Ansible
- Docker
- Cloudflare (DNS, R2)
- GitHub Actions
- SPSauvegardes & PRA
- Linux
Résultats
- ✦Staging à chaque push, production à la demande
- ✦Smoke test après chaque déploiement
- ✦Serveur reconstructible depuis le repo et les sauvegardes
Le récit
Comment ça marche
Je raconte ici le parcours d’un opérateur, c’est-à-dire le mien : du repo jusqu’à une app en ligne, puis le jour où l’on veut supprimer quelque chose.
1. Un repo, une couche par dossier
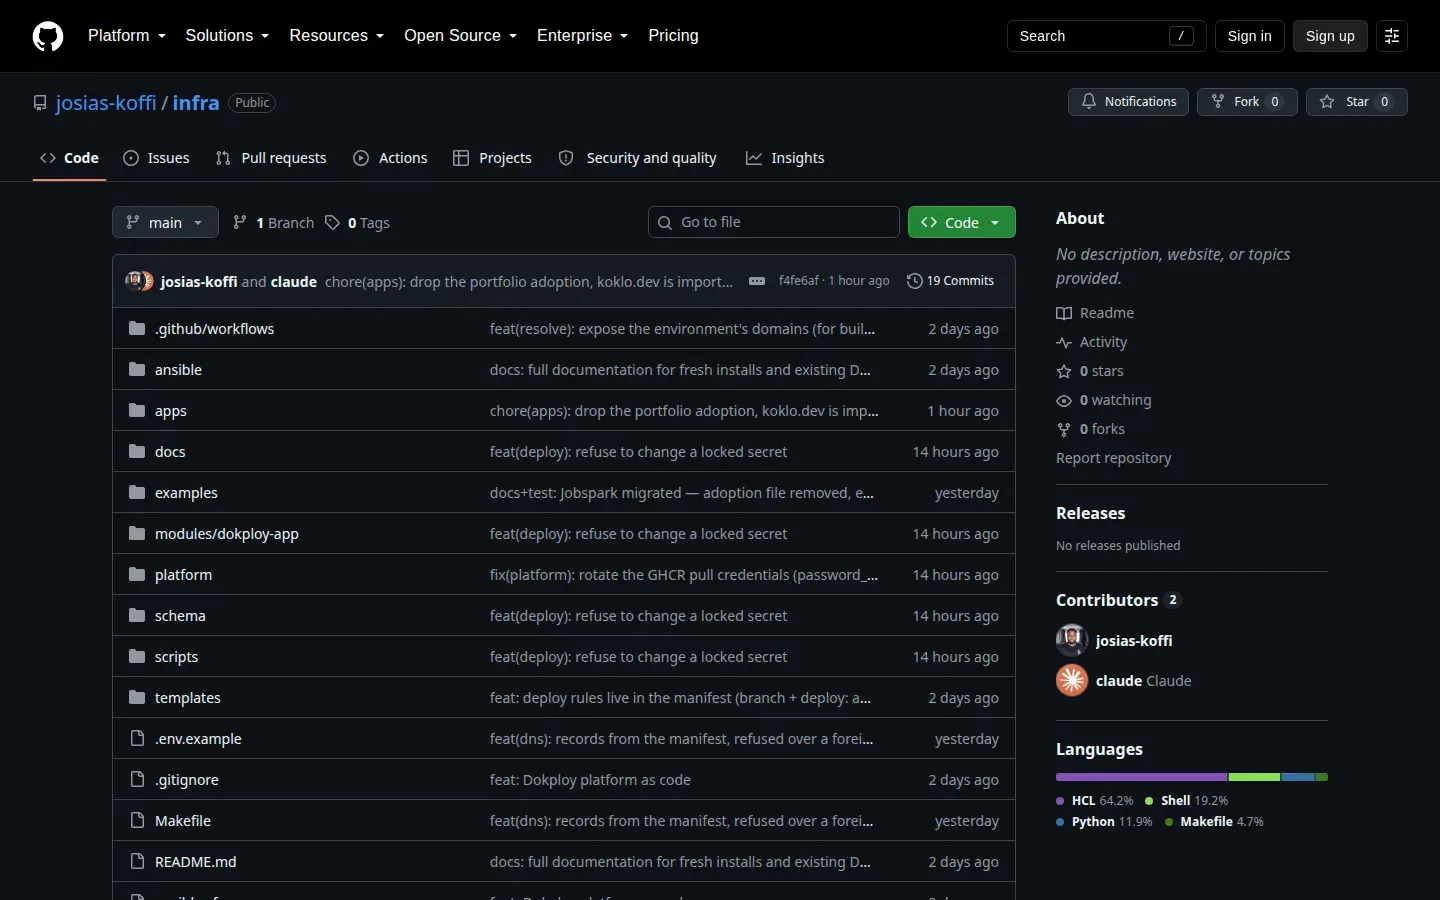
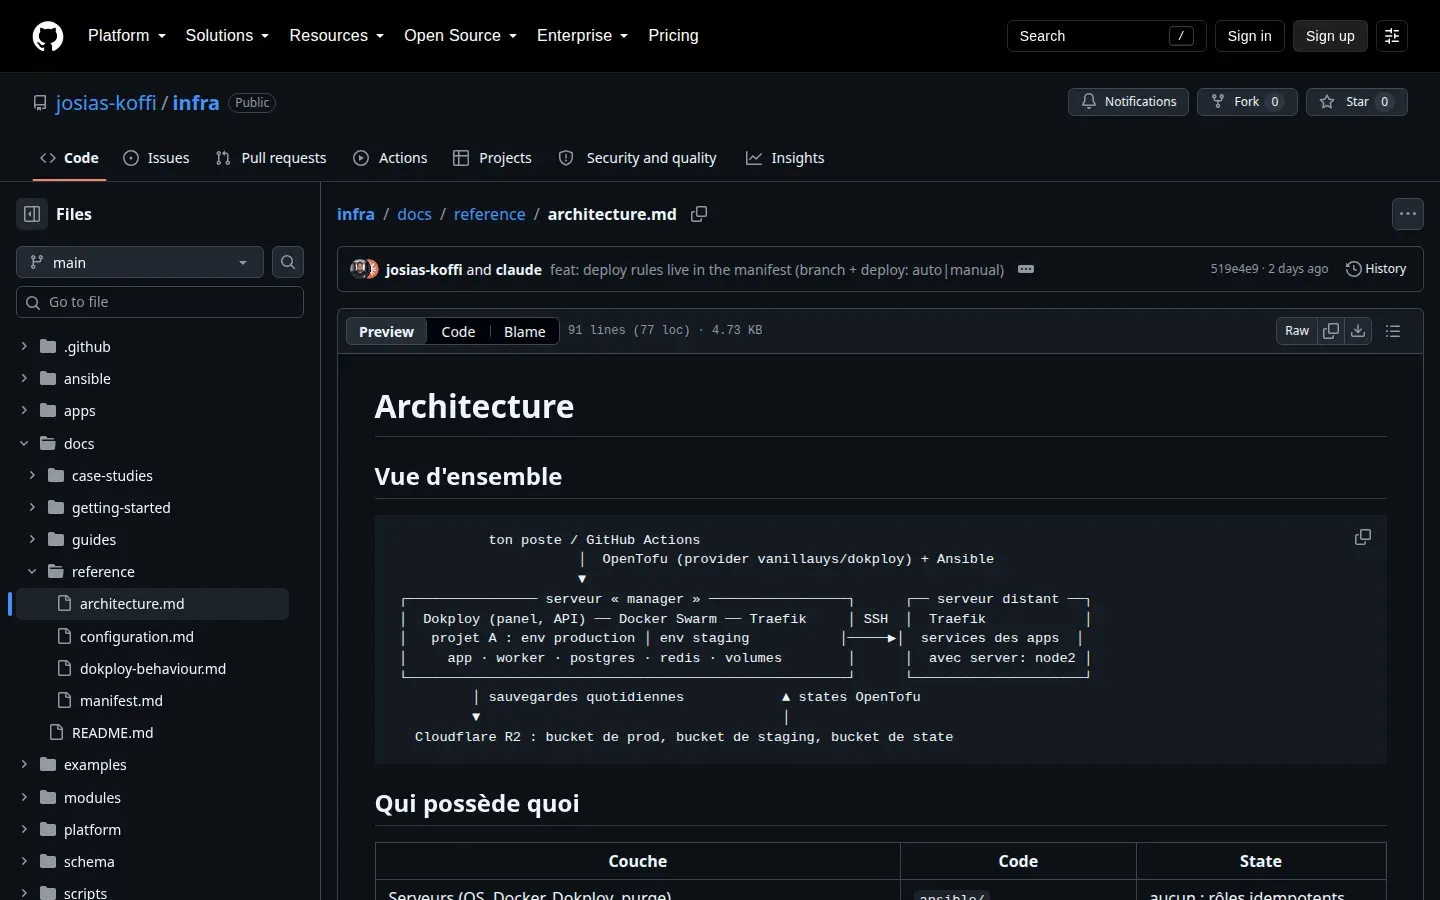
Tout tient dans un repo public. ansible/ prépare les serveurs (Docker, Dokploy à version figée, purge). platform/ décrit l’instance Dokploy elle-même : réglages, destinations de sauvegarde, registre, serveurs distants. apps/project et apps/env sont les deux roots OpenTofu lancés pour chaque app, et modules/dokploy-app traduit un manifest en ressources. Le repo d’une app, lui, ne contient que son .deploy/manifest.yaml et un workflow de quelques lignes.
2. Un push sur develop déploie le staging
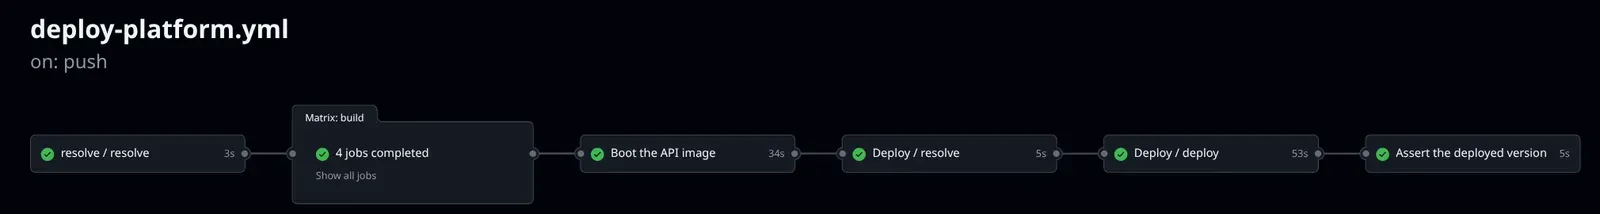
Le premier job, resolve, est un workflow réutilisable : il lit le manifest et décide si cet événement déploie, vers quel environnement et avec quel tag. Ici, Jobspark construit ses quatre images, démarre l’image de l’API pour vérifier qu’elle boote, puis appelle deploy.yml. Le dernier job compare la version servie par l’API au SHA déployé.
3. Un push sur main ne déploie rien
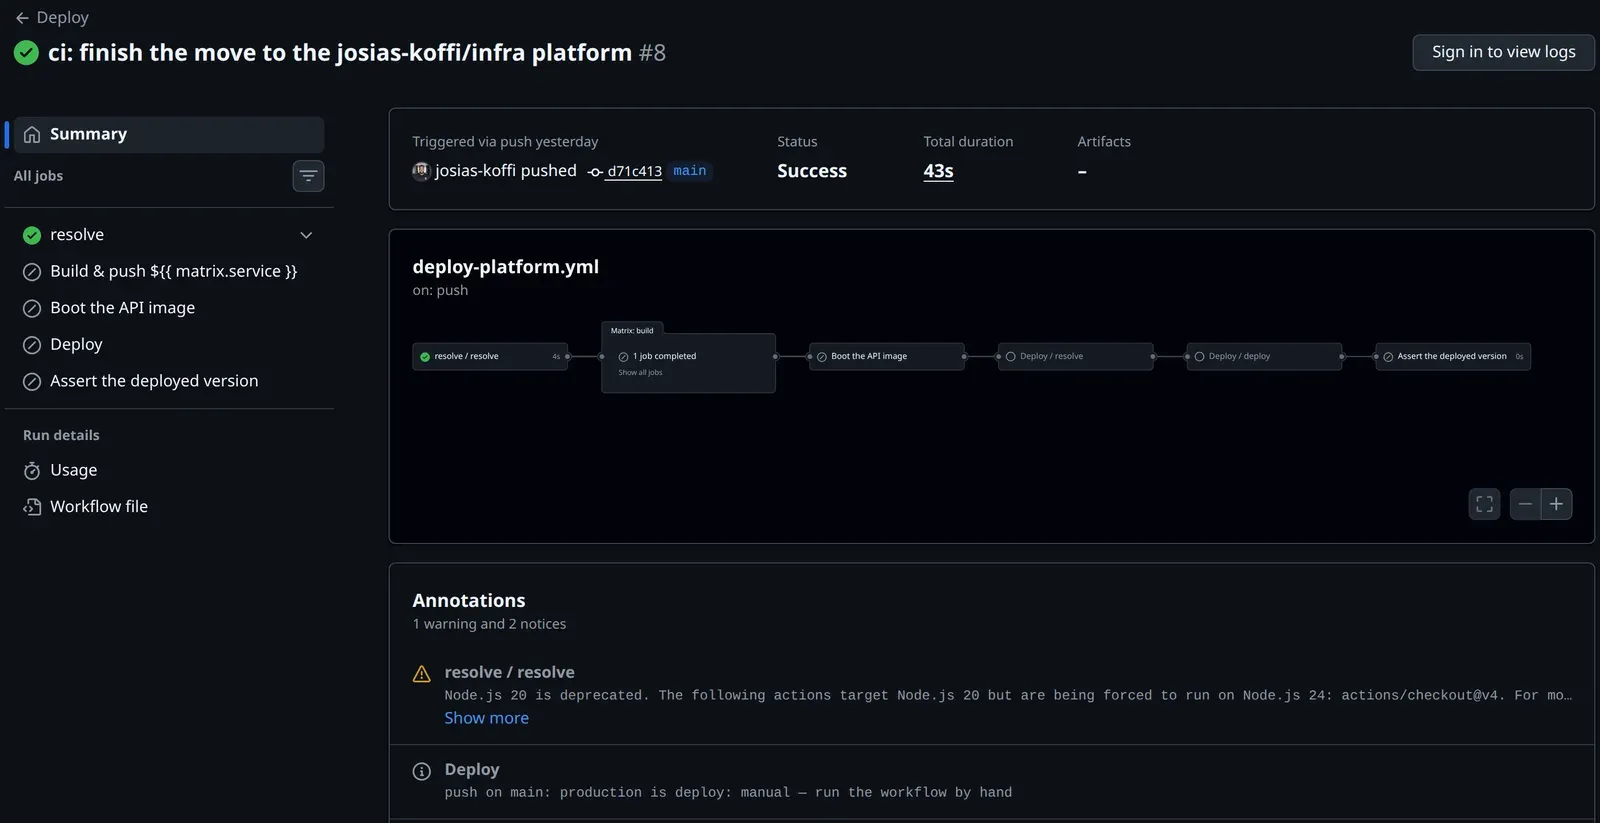
La production est en deploy: manual. Le run s’arrête après resolve et laisse une notice. Pour mettre en prod, je relance le workflow à la main depuis main, avec le tag déjà validé en staging. Le même bouton sert au rollback : on redonne un ancien tag.
4. Le plan est lu avant d’être appliqué
scripts/deploy-app.sh valide le manifest, vérifie le DNS, applique le projet, puis planifie l’environnement. J’ai rejoué ce plan sur le manifest de ce site avec le provider simulé des tests du module : onze ressources pour le staging du portfolio, sans aucune connexion à Dokploy.
On y lit le contenu du manifest : trois applications (front, CMS, MinIO), leurs trois domaines en HTTPS, la base Postgres et sa sauvegarde, le volume de MinIO et sa sauvegarde, et l’empreinte des secrets verrouillés. Les enregistrements DNS Cloudflare s’ajoutent dans apps/env, hors du module.
5. Supprimer, c’est un autre chemin
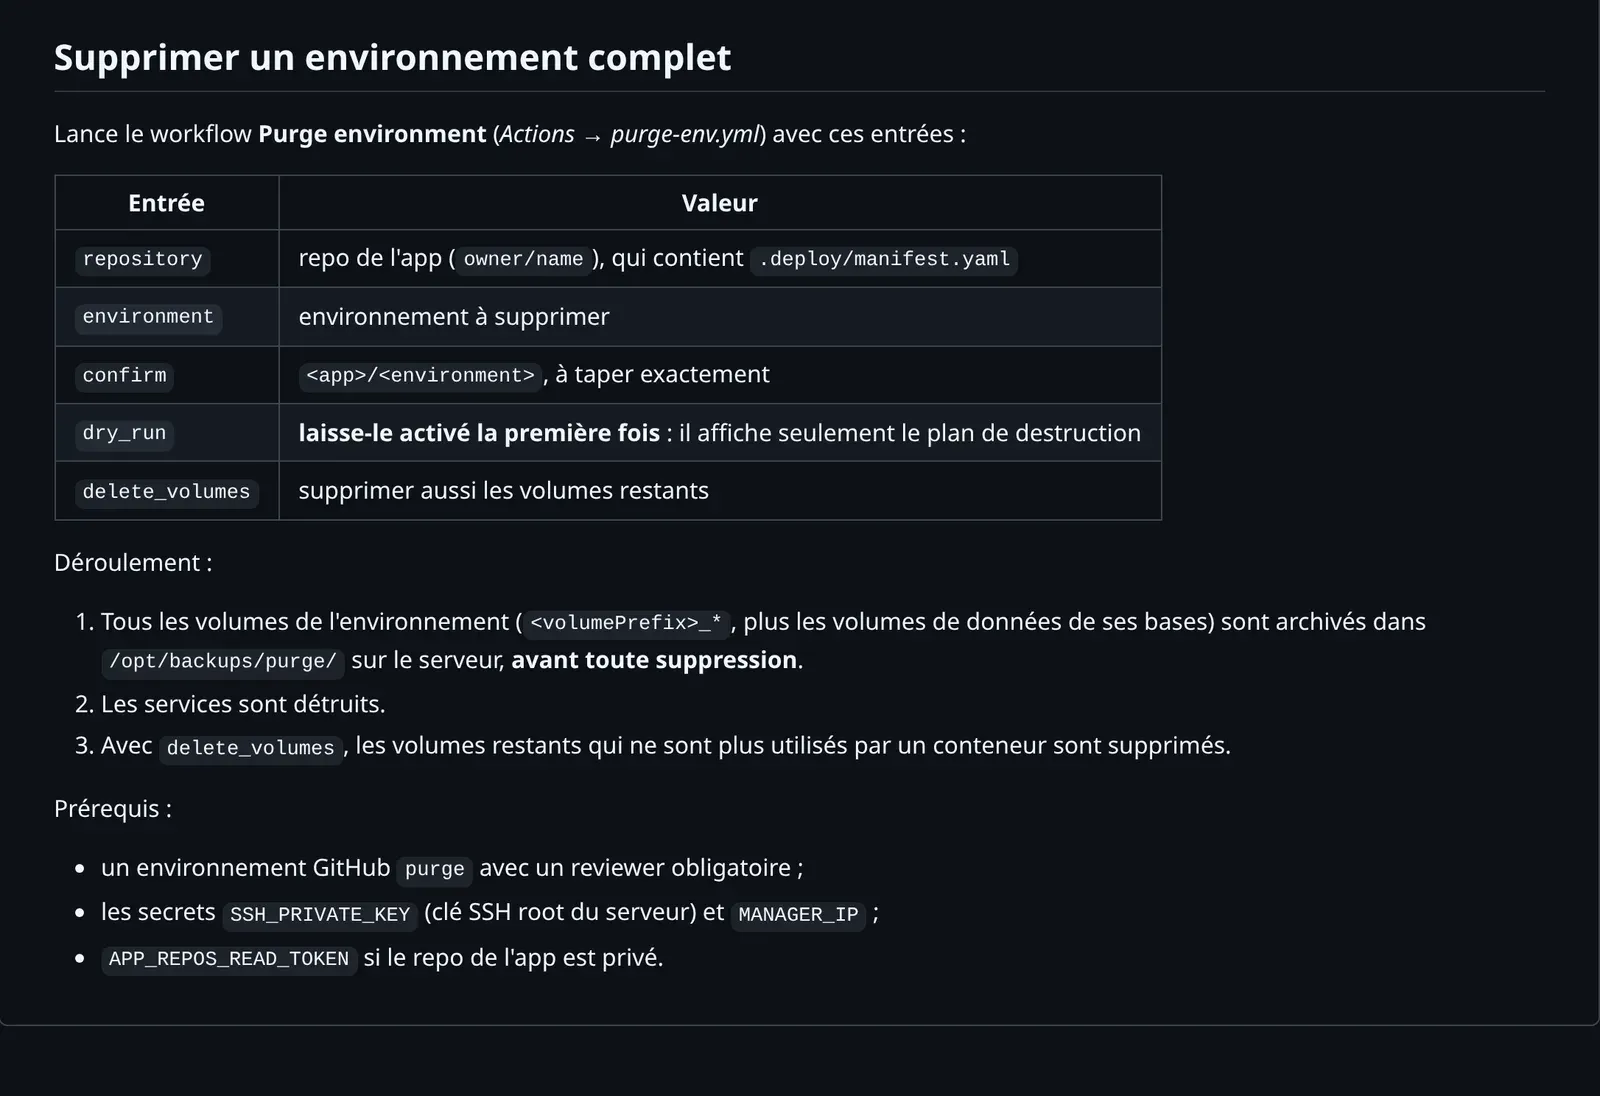
Retirer une base du manifest ne la supprime pas : le déploiement refuse. Pour retirer un environnement entier, il y a le workflow purge-env. Il demande un reviewer, une confirmation tapée <app>/<env> et tourne en dry run la première fois. Il archive tous les volumes sur le serveur avant de détruire quoi que ce soit.
6. Reprendre l’existant sans rien recréer
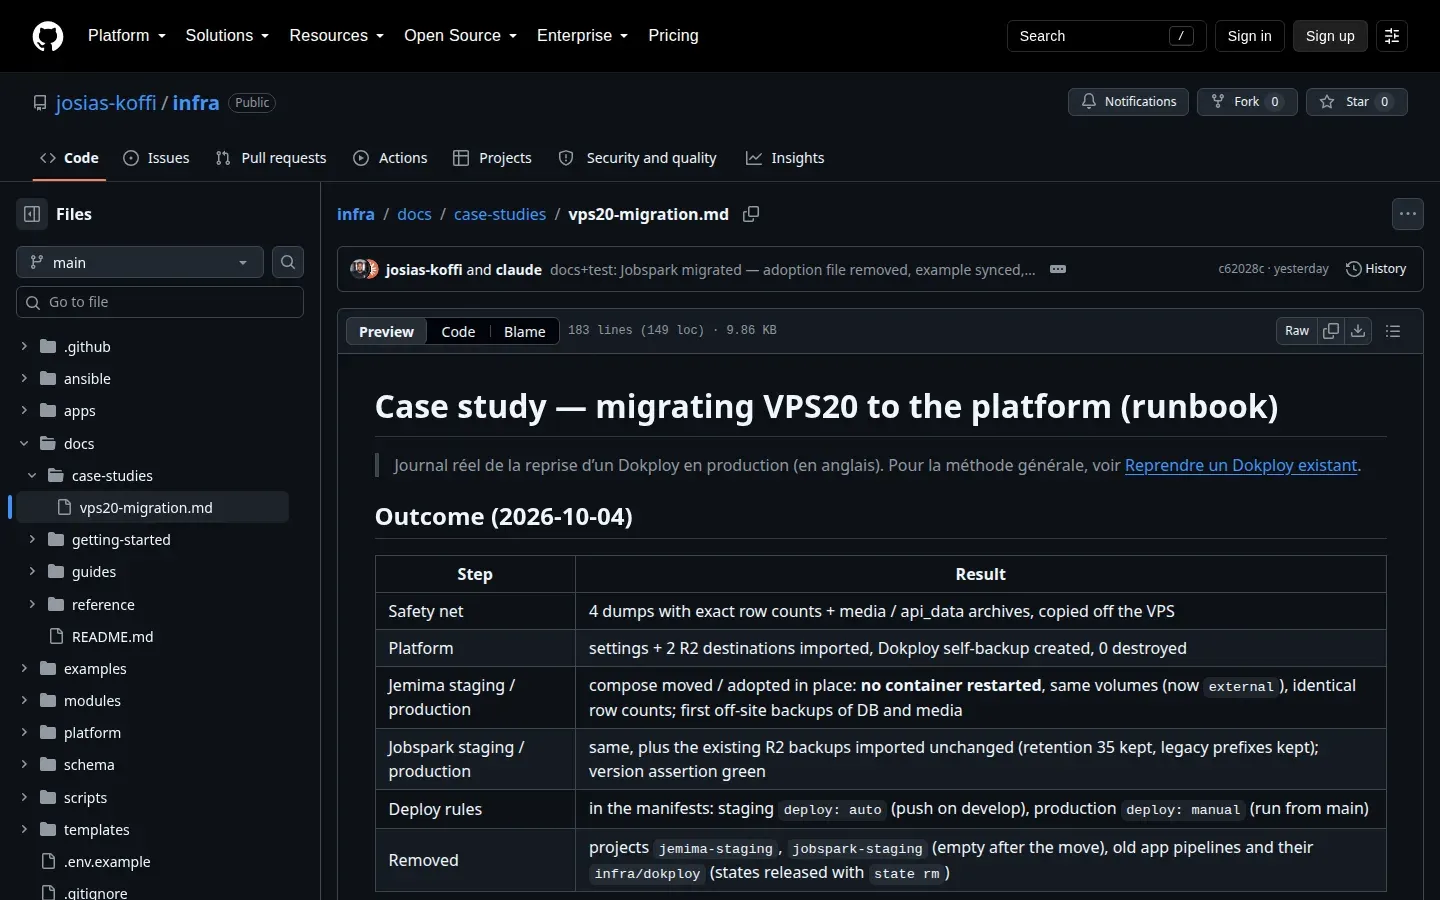
Les stacks de Jobspark et de Jémima tournaient déjà sur Dokploy, en docker-compose. La plateforme les a reprises par import : les composes ont changé d’environnement sur place, sans redémarrer de conteneur. Le journal complet est dans docs/case-studies, avec la carte des volumes réellement montés.
Sous le capot
Du manifest aux ressources
Chaque étape peut arrêter la suite. La validation contrôle le schéma JSON puis la cohérence : un uses doit nommer un composant connu, chaque domaine doit exister dans chaque environnement. check-dns refuse un nom déjà pris par un enregistrement qui n’a pas été créé par la plateforme. apps/project et apps/env ont des states séparés, un par environnement, stockés dans R2.
La garde contre les plans destructifs
Le plan est enregistré dans un fichier, puis relu en JSON. S’il contient la suppression d’une ressource avec état, le script s’arrête. Il fait de même si l’empreinte SHA-256 d’un secret verrouillé change : une base ne lit son mot de passe qu’à la création de son volume, et changer la variable ensuite casserait les connexions. Une rotation voulue passe par ALLOW_SECRET_CHANGE, nom par nom.
plan = json.load(sys.stdin)
changes = plan.get("resource_changes", [])
stateful = ("dokploy_postgres", "dokploy_mysql", "dokploy_mariadb", "dokploy_mongo",
            "dokploy_redis", "dokploy_compose", "dokploy_mount")
bad = [r["address"] for r in changes
       if r["type"] in stateful and "delete" in r["change"]["actions"]]
if bad:
    print("Refusing to destroy stateful resources:", *bad, sep="\n  ")
    print("Use the purge-env workflow (protected) for an intended removal.")
    sys.exit(1)
Pour le vérifier, j’ai retiré la base du manifest du portfolio dans une copie du module. Le plan simulé propose bien de détruire Postgres et sa sauvegarde, et le garde-fou, extrait tel quel du script, le refuse :
Plusieurs serveurs
platform/nodes.yaml liste les serveurs. Aujourd’hui il n’y en a qu’un, vps20, en rôle manager : il porte le panel Dokploy et les services. Un second serveur se prépare avec make add-node, puis se déclare en rôle remote ; Dokploy le pilote en SSH et il garde son propre Traefik. Une app choisit sa machine avec server:. Il n’y a pas de réseau entre les serveurs : une app et ses dépendances vivent au même endroit.
Les tests
make test valide les manifests d’exemple, lance les tests du module avec un provider simulé et valide les trois roots. Les tests vérifient des détails qui ont compté en production, par exemple que Jobspark garde le préfixe de ses volumes réels et l’arborescence historique de ses sauvegardes R2.
Ce que j’en retiens
- Vérifier Dokploy avant de lui faire confiance. Sur un projet jetable, j’ai constaté que supprimer un compose supprime ses volumes nommés, sauf s’ils sont
external. D’oùexternalVolumes: trueobligatoire en mode compose, ettofu state rmplutôt quedestroypour libérer les anciens states. Ces constats sont notés dansdocs/reference/dokploy-behaviour.md. - Mettre les règles dans le manifest, pas dans le workflow. Le workflow d’une app ne décide rien. La branche de chaque environnement et le mode
autooumanualsont dans le même fichier que les services, et se relisent en revue de code. - Séparer les states par environnement. Un apply de staging ne peut ni lire ni modifier la prod. C’est un peu plus de plomberie (
terraform_remote_stateen lecture seule), mais c’est ce qui m’a permis de migrer le staging d’abord, sans risque pour la prod.
Galerie
Parlons-en. Décrivez votre besoin en quelques lignes, je reviens vers vous sous 48 h.