Une plateforme edtech multi-tenant quitte une base managée et un PaaS qui ne la servait plus. Pourquoi, comment, ce qui a cassé dans la nuit, et ce que j’en ai gardé pour la suite.
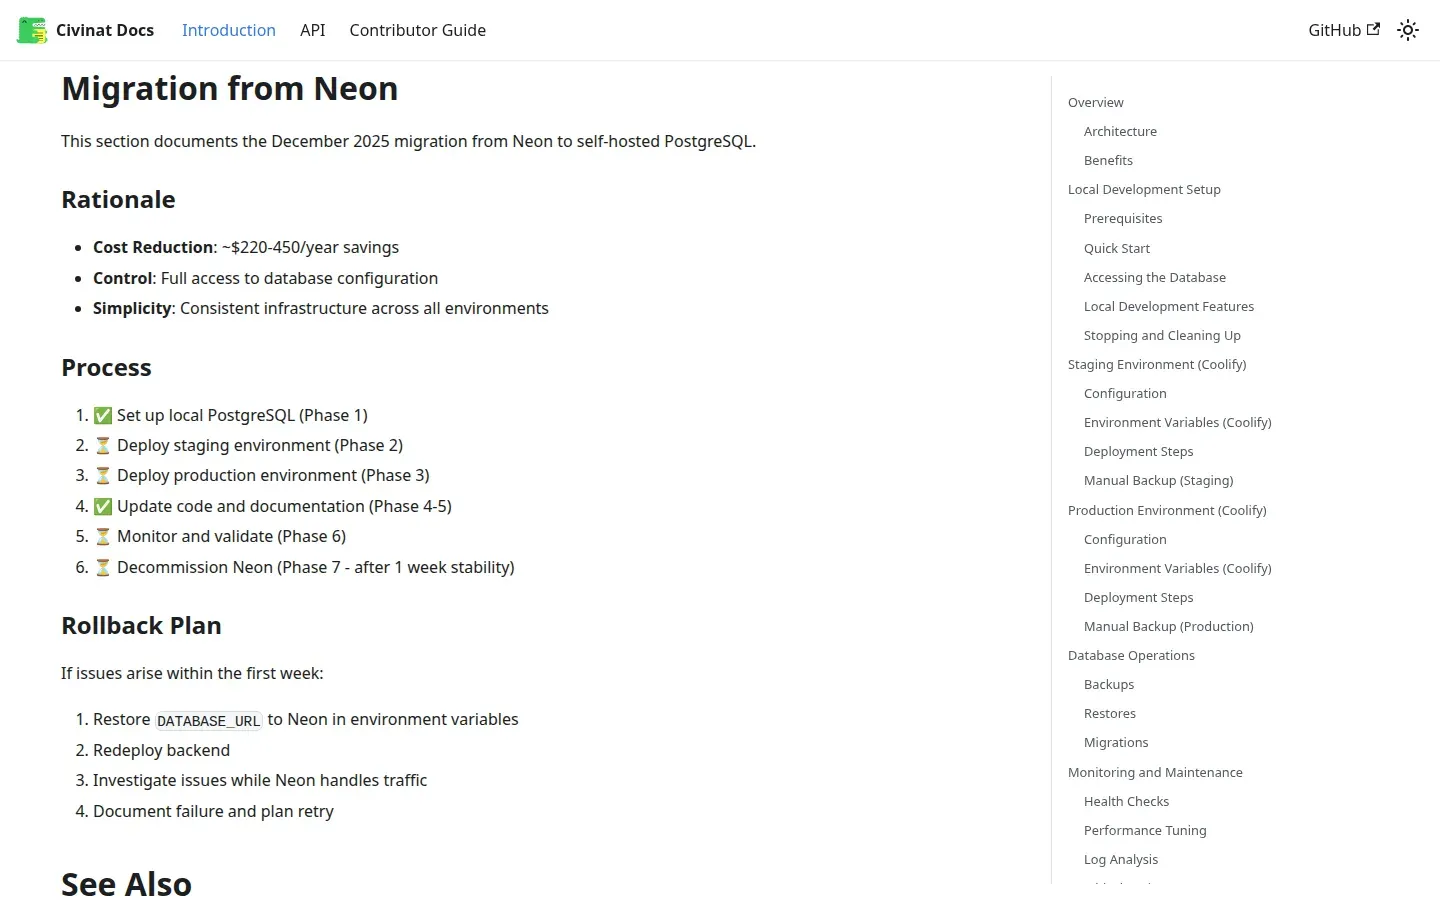
En octobre 2025, j’ai déplacé la base de Civinat vers Neon et le déploiement vers Coolify. Deux mois plus tard, j’ai fait le chemin inverse pour la base, et changé de PaaS en une nuit. Ce n’était pas prévu comme ça. Voici ce qui s’est passé, à partir des notes, des docs et du git log du monorepo.
Le point de départ
Civinat est une plateforme d’apprentissage multi-tenant : une API NestJS avec Prisma, un front Next.js, une base PostgreSQL et des médias sur Cloudflare R2. Le 26 octobre 2025, le commit « finalize the migration to neon » remplace le Postgres en conteneur par Neon, du Postgres serverless. La doc de l’époque donne les raisons : pas de conteneur de base à gérer, un pooler de connexions intégré, des sauvegardes et du point-in-time recovery fournis.
Le même mois, l’app part sur Coolify, installé sur un VPS. Les fichiers docker-compose.coolify*.yml et plusieurs guides (COOLIFY-DEPLOYMENT-GUIDE.md, COOLIFY-PATH-EXPLAINED.md) datent de cette période. Le second explique en détail un piège de monorepo : avec un « Base Directory », Coolify change le contexte de build, et les COPY civinat-front/… du Dockerfile ne trouvent plus rien.
Pourquoi sortir
La section « Migration from Neon » de la doc liste trois raisons : le coût, le contrôle sur la configuration de la base, et la cohérence entre environnements. Sur le coût, la doc donne une estimation de 220 à 450 $ d’économie par an. C’est une estimation faite avant la migration, pas une mesure.
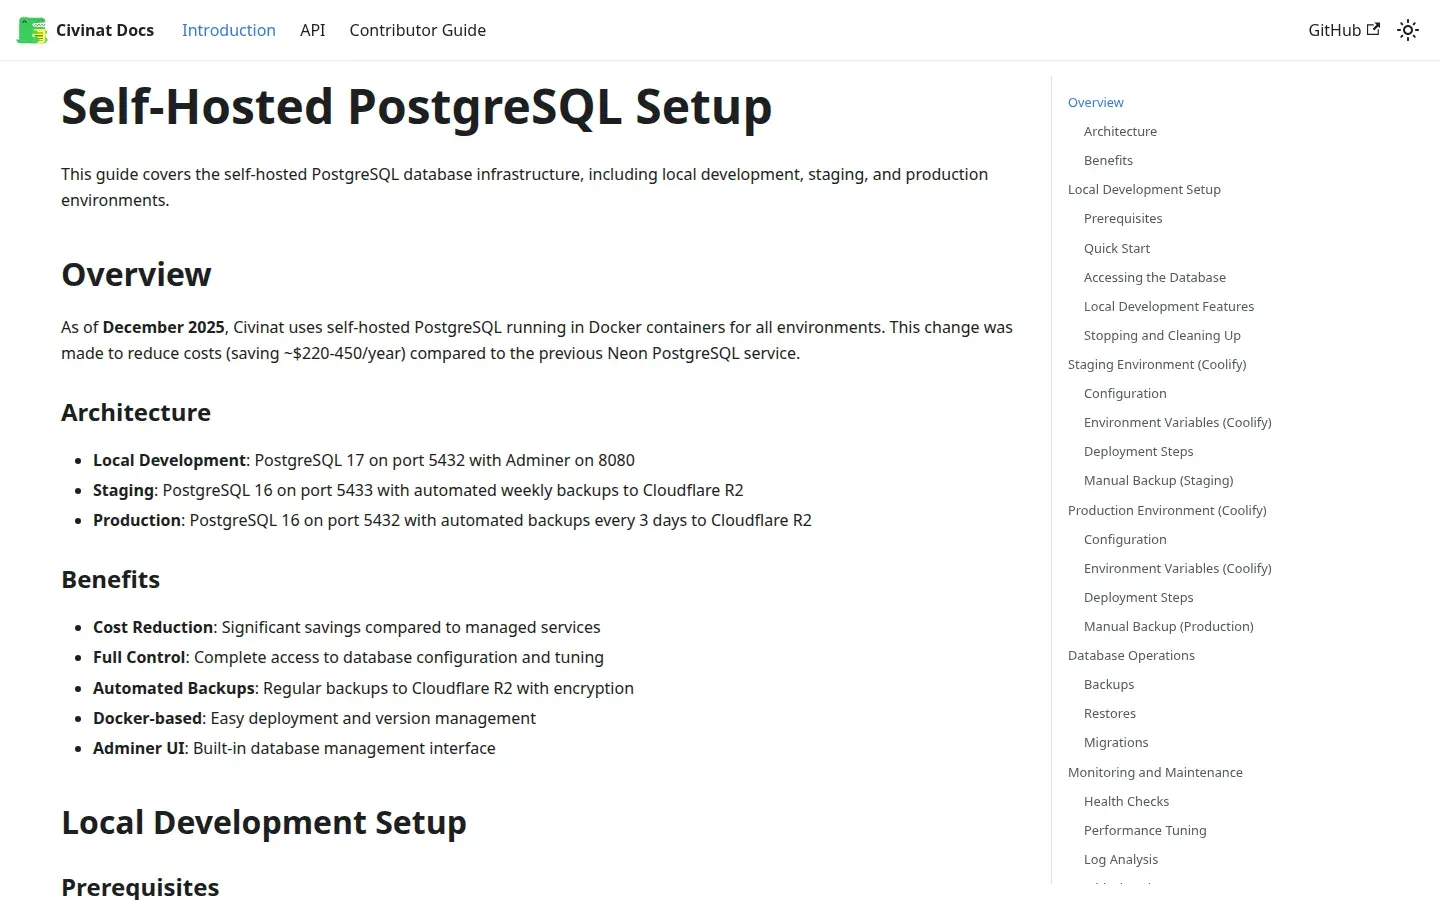
La cohérence comptait autant. Avec Neon en production et un Postgres en conteneur en local, on avait deux mondes : une URL avec -pooler et sslmode=require d’un côté, un hostname Docker de l’autre, et des messages d’erreur dans l’entrypoint qui parlaient du tableau de bord Neon. Le VPS tournait de toute façon : dans le tableau de coûts de infrastructure/README.md, la base auto-hébergée ne coûte rien de plus.
Migrer la base
J’ai commencé par écrire le plan, le 2 décembre (DATABASE_BACKUP_RESTORE.md), avant de toucher à la production. Il tient en trois idées : un dump au format custom, une restauration avec des options qui ignorent les propriétaires et les droits, et une marche arrière simple.
# Neon tourne en PostgreSQL 17 : on prend un pg_dump de la même version
docker run --rm -v $(pwd):/backups postgres:17-alpine pg_dump \
  "postgresql://USER:PASSWORD@ENDPOINT.neon.tech/DATABASE?sslmode=require" \
  -Fc -f /backups/backup_$(date +%Y%m%d).dump

# Puis restauration dans le conteneur cible
docker cp backup.dump CONTAINER:/tmp/
docker exec CONTAINER pg_restore -U civinat -d civinat \
  --clean --if-exists --no-owner --no-privileges /tmp/backup.dump
Le détail qui compte est l’image postgres:17-alpine. Neon tourne en PostgreSQL 17, et un pg_dump plus ancien que le serveur refuse de travailler. Plutôt que d’installer la bonne version sur ma machine, je lance le client dans un conteneur jetable de la même version. Les options --no-owner --no-privileges évitent les « permission denied » à la restauration : on ne rejoue ni les propriétaires ni les droits de Neon, on prend ceux de la nouvelle base.
Le retour arrière tient en une variable. Tant que Neon n’est pas supprimé, il suffit de remettre l’ancienne DATABASE_URL et de redéployer le backend. Cette marche arrière m’a laissé travailler sereinement : rien de ce que je faisais n’était définitif.
Ce qui a cassé
La configuration Postgres
Premier essai, premier échec : je montais un postgresql.conf complet dans le conteneur, et ses réglages ne passaient pas avec l’image Alpine. Le commit 94ae31a5 retire le fichier et passe chaque réglage en argument -c dans la commande du conteneur. C’est moins élégant, mais tout est lisible au même endroit.
Les versions
Le 4 décembre, la base de staging passe de PostgreSQL 17 à 16. Dans le commit suivant, l’image de sauvegarde passe à 17 ; dans celui d’après, elle revient à 16. La leçon : la sauvegarde embarque son propre pg_dump, et sa version doit suivre celle du serveur. Le retour à 16 crée aussi un écart avec Neon, en 17 : la doc consacre une section au « version mismatch on restore ».
Une chaîne vide
Juste après minuit le 5 décembre, le backend refuse de démarrer. Le schéma de validation Joi déclarait R2_ENDPOINT comme une URI optionnelle. Mais une variable déclarée dans le compose et vide côté PaaS arrive comme une chaîne vide, pas comme une absence. Et une chaîne vide n’est pas une URI. Le commit bfa37dbb ajoute .allow(''). Une ligne, après avoir retiré puis remis la variable.
Le proxy de Coolify
Le vrai blocage est venu du proxy. Les symptômes, notés dans backend/DEPLOYMENT.md : le conteneur est sain, le health check répond en interne, mais l’URL publique tombe en timeout après 15 secondes, et les logs du backend ne montrent aucune requête. Le Caddy de Coolify avait configuré le service avec des directives try_files, comme un site statique, au lieu d’un simple reverse_proxy vers une API.
Le git log raconte la nuit. Exposer le port, le retirer, ajouter des labels caddy.reverse_proxy, les enlever, essayer d’écraser try_files par des labels vides, puis tenter un nginx interne :
         labels:
             - "coolify.managed=true"
             - "coolify.type=application"
             - "coolify.environment=production"
+            # Override try_files by setting it to empty
+            - "caddy.try_files="
+            - "caddy_0.try_files="
+            - "caddy_1.try_files="
À 3 h 17, j’ai arrêté de me battre contre le proxy. Le commit suivant s’appelle « passing to dockploy ». Dokploy utilise Traefik, configuré par labels, et le problème try_files disparaît avec Caddy. Le même jour, la base, le backend et le front sont passés sur Dokploy.
La stack sur Dokploy
Chaque bloc est un service Docker Compose dans Dokploy. Traefik reçoit le trafic derrière Cloudflare. Le front répond sur civinat.com et le wildcard *.civinat.com, une organisation par sous-domaine. Le backend répond sur api.civinat.com. Côté serveur, le front appelle le backend par le réseau Docker interne, sans repasser par Internet. Adminer est exposé derrière une authentification basique.
Trois choix viennent directement de ce qui avait cassé avant :
- Des volumes Docker nommés plutôt que des montages de dossiers, pour rester compatible avec Swarm, que Dokploy utilise.
- Un réseau overlay `attachable` par environnement, que la base crée et que le backend rejoint, en plus du réseau de Traefik.
- *Les variables `NEXT_PUBLIC_
en arguments de build** : Next.js les fige dans le bundle au build, les mettre seulement dans l’environnement d’exécution ne suffit pas
postgres-backup:
    image: eeshugerman/postgres-backup-s3:16
    environment:
        POSTGRES_HOST: postgres-production
        S3_ENDPOINT: https://${R2_ACCOUNT_ID}.r2.cloudflarestorage.com
        S3_BUCKET: ${R2_BUCKET}
        S3_PREFIX: backups/postgresql-production
        # Backup schedule: Daily at 3 AM Paris time
        SCHEDULE: "0 3 * * *"
        BACKUP_KEEP_DAYS: 30
        POSTGRES_EXTRA_OPTS: "--clean --if-exists --no-owner --no-acl"
        ENCRYPTION_PASSWORD: ${BACKUP_ENCRYPTION_PASSWORD}
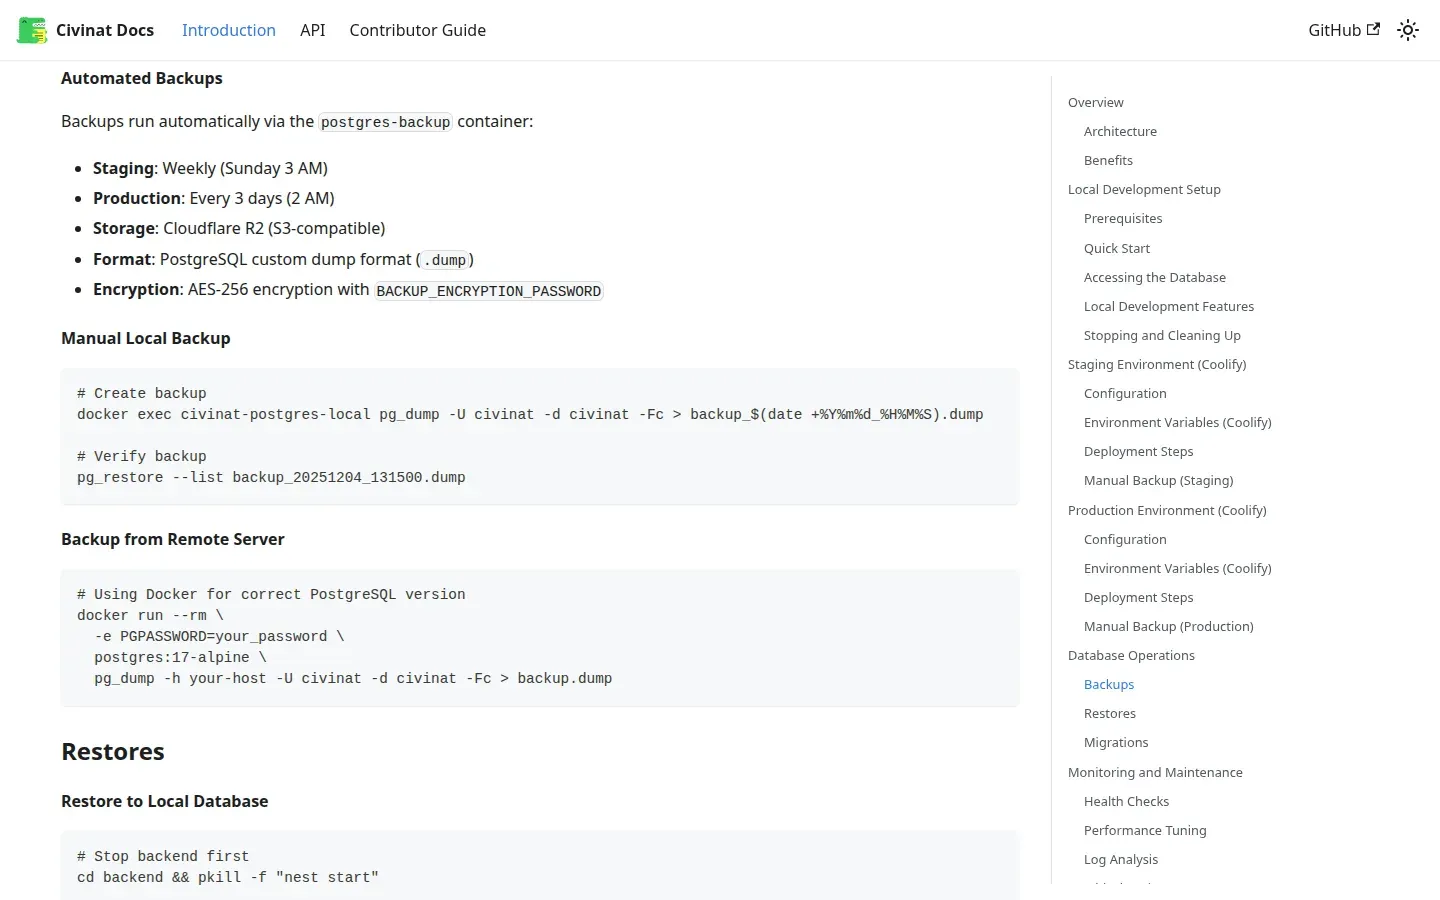
La sauvegarde est un conteneur à côté de la base : un dump par jour à 3 h, chiffré, envoyé vers R2, gardé 30 jours. C’est la partie que Neon fournissait sans rien faire. Il faut maintenant la tenir soi-même.
Le résultat
Civinat tourne aujourd’hui sur Dokploy, avec sa base PostgreSQL à côté. Au moment où j’écris, le health check de production répond :
Ce que je n’ai pas fait proprement, je le note aussi. La doc n’a pas suivi : elle parle encore d’environnements Coolify, de sauvegardes « tous les 3 jours », et la liste des phases de migration garde des sabliers alors que la bascule a eu lieu. Et l’entrypoint du backend, quand prisma migrate deploy échoue, tente un prisma db push --accept-data-loss. Pratique en développement, dangereux en production.
Et la PaaS as code ?
Civinat tourne encore avec ses fichiers compose, gérés depuis l’interface de Dokploy : il n’est pas encore décrit dans ma plateforme d’hébergement as code. Mais quand je relis cette migration, plusieurs règles de cette plateforme répondent aux problèmes rencontrés ici :
- une base déclarée dans le manifeste est sauvegardée chaque jour vers R2 par défaut, sans sidecar à écrire ;
- un déploiement refuse un plan qui détruirait une ressource avec état ;
- la configuration vit dans un fichier versionné, pas dans une interface ni dans une doc qui prend du retard.
Ce que j’en retiens
- Un service managé ne fait pas que stocker. Neon fournissait les sauvegardes, le point-in-time recovery et le pooler. En le quittant, chaque point est devenu une ligne de compose à écrire et à vérifier.
- Prévoir la marche arrière avant de partir. Le retour arrière en une variable, et un plan qui gardait Neon une semaine après la bascule, rendaient chaque étape réversible.
- Savoir quand arrêter de se battre contre l’outil. Une nuit de labels Caddy n’a rien réglé. Passer base, backend et front sur Dokploy a tenu en une journée de commits.
#postgresql#neon#coolify#dokploy#traefik#migration#cloudflare-r2#self-hosting#docker