Des stacks docker-compose déployées à la main aux services Dokploy générés depuis un manifest : le chemin, les choix et les pièges.
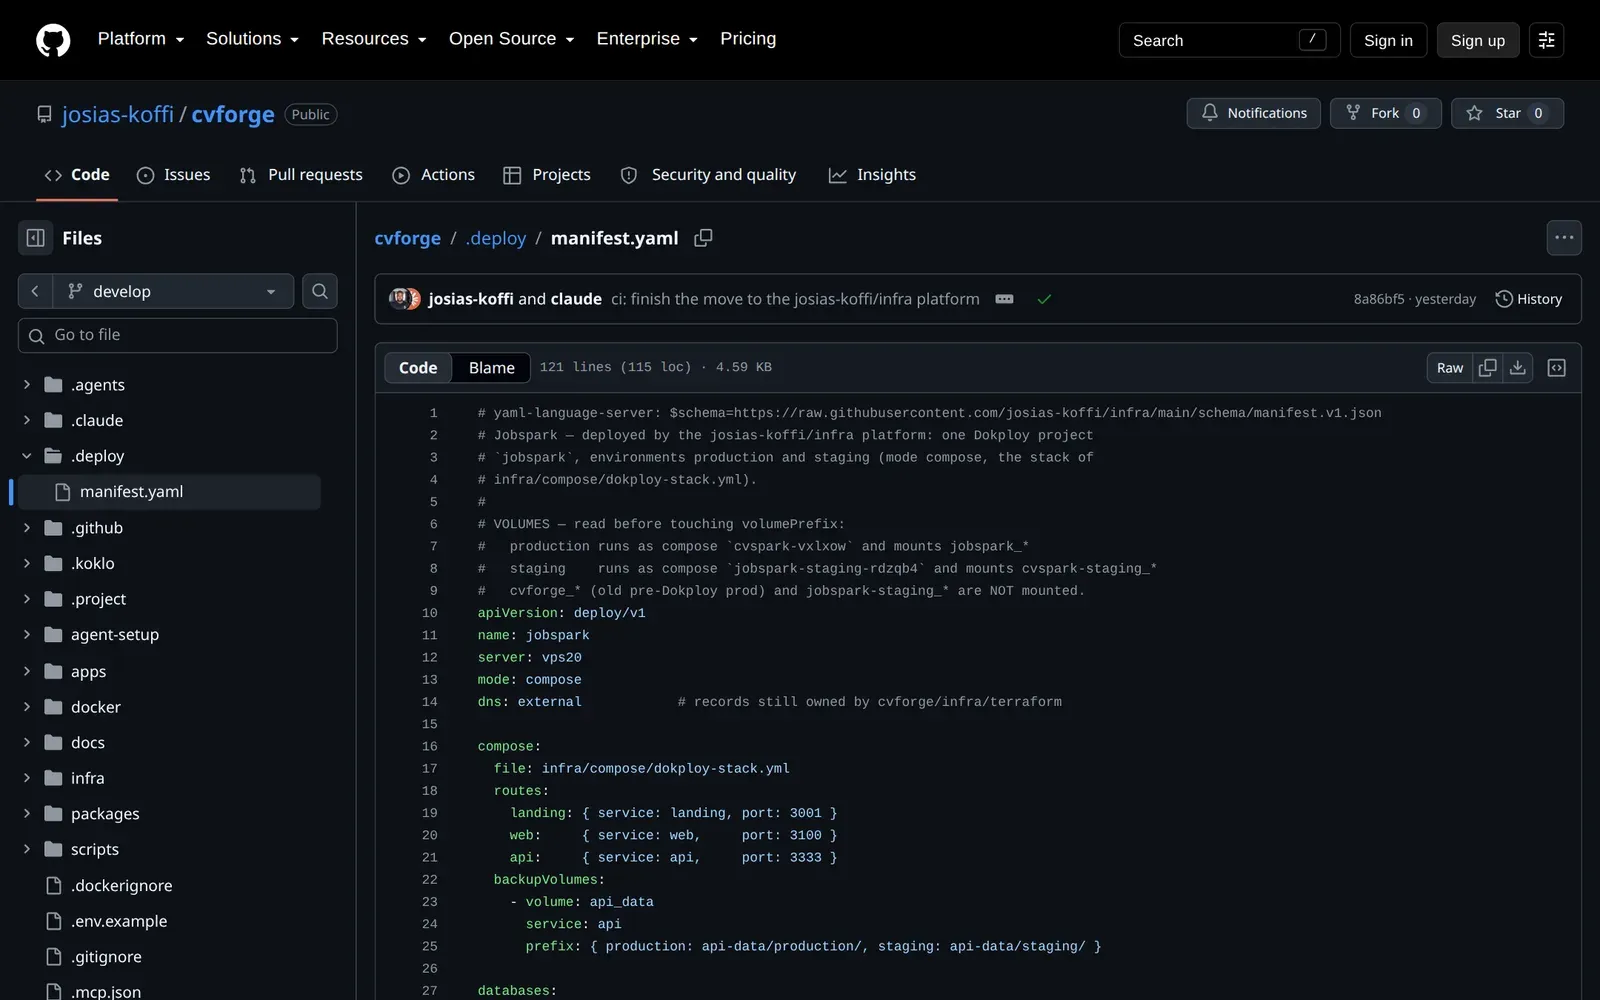
Pendant longtemps, chacune de mes apps se déployait à sa façon. Jobspark avait ses pipelines et son dossier Terraform, Jémima les siens, et deux services tournaient en docker-compose hors de tout panel. Les volumes avaient des préfixes hérités de noms de projet abandonnés. Une des apps n’avait aucune sauvegarde hors du serveur.
Ça marche, jusqu’au jour où il faut restaurer une base, ajouter une machine ou simplement se souvenir de quel volume est le bon. J’ai donc mis la plateforme sous code, avec une règle simple : une app, un fichier YAML.
Décrire, pas déployer
Chaque app pose un fichier .deploy/manifest.yaml à côté de son code. Elle y décrit ce qu’elle exécute : ses apps, ses workers, ses bases, ses caches, ses environnements et leurs domaines. Elle ne dit rien de la façon de le déployer.
La plateforme, dans un repo à part, lit ce fichier et crée le reste dans Dokploy : un projet, un environnement par étape, un service par composant, les domaines en HTTPS, les enregistrements DNS chez Cloudflare et les sauvegardes vers R2. Le repo de l’app ne contient ni Terraform ni script de déploiement.
Le repo de l’app ne contient que son manifest. Le moteur vit dans le repo d’infra, et le workflow réutilisable le récupère à chaque déploiement.
Un vrai manifest : celui de ce site
Voici, à peine raccourci, le manifest qui déploie le site que vous lisez. Quatre composants : le front Next.js, le CMS Payload, un MinIO pour les médias et une base Postgres.
apiVersion: deploy/v1
name: portfolio
server: vps20
mode: services

secrets: [DB_PASSWORD, PAYLOAD_SECRET, REVALIDATE_SECRET, CMS_API_KEY,
          MINIO_ACCESS_KEY, MINIO_SECRET_KEY, ADMIN_EMAIL, ADMIN_PASSWORD, …]
lockedSecrets: [PAYLOAD_SECRET, MINIO_ACCESS_KEY, MINIO_SECRET_KEY]

apps:
  web:
    image: ghcr.io/josias-koffi/portfolio-web
    registry: ghcr                      # paquet privé
    port: 3000
    domain: web
    healthcheck: /api/health
    uses: [cms]                         # CMS_URL=https://<domaine cms>
    vars:
      SITE_URL: https://${domains.web}
    resources: { cpus: 0.5, memory: 512m }
  cms:
    image: ghcr.io/josias-koffi/portfolio-cms
    port: 3000
    domain: cms
    healthcheck: /api/health
    uses: [db, web]                     # DATABASE_URL, WEB_URL
    vars:
      S3_ENDPOINT: https://${domains.media}
      S3_ACCESS_KEY: ${secrets.MINIO_ACCESS_KEY}
    resources: { cpus: 1, memory: 1g }
  media:
    image: ghcr.io/josias-koffi/minio
    tag: RELEASE.2025-04-22T22-12-26Z
    port: 9000
    domain: media
    volumes: { data: /data }            # <volumePrefix>_data, sauvegardé chaque jour

databases:
  db: { type: postgres, version: 16-alpine, database: portfolio, user: portfolio }

environments:
  production:
    branch: main
    deploy: manual                      # un push sur main ne déploie jamais
    domains: { web: koklo.dev, cms: cms.koklo.dev, media: media.koklo.dev }
  staging:
    branch: develop                     # deploy: auto (défaut)
    domains: { web: portfolio-staging.koklo.dev, cms: cms-staging.koklo.dev,
               media: media-staging.koklo.dev }
    overrides:
      apps: { cms: { resources: { memory: 768m } } }
Quelques détails comptent. uses relie les composants : le CMS reçoit DATABASE_URL parce qu’il utilise db, et WEB_URL parce qu’il utilise web. Les valeurs de vars sont des modèles, avec ${domains.media} ou ${secrets.MINIO_ACCESS_KEY}, résolus pour chaque environnement. overrides change une seule valeur pour un seul environnement, ici la mémoire du CMS en staging.
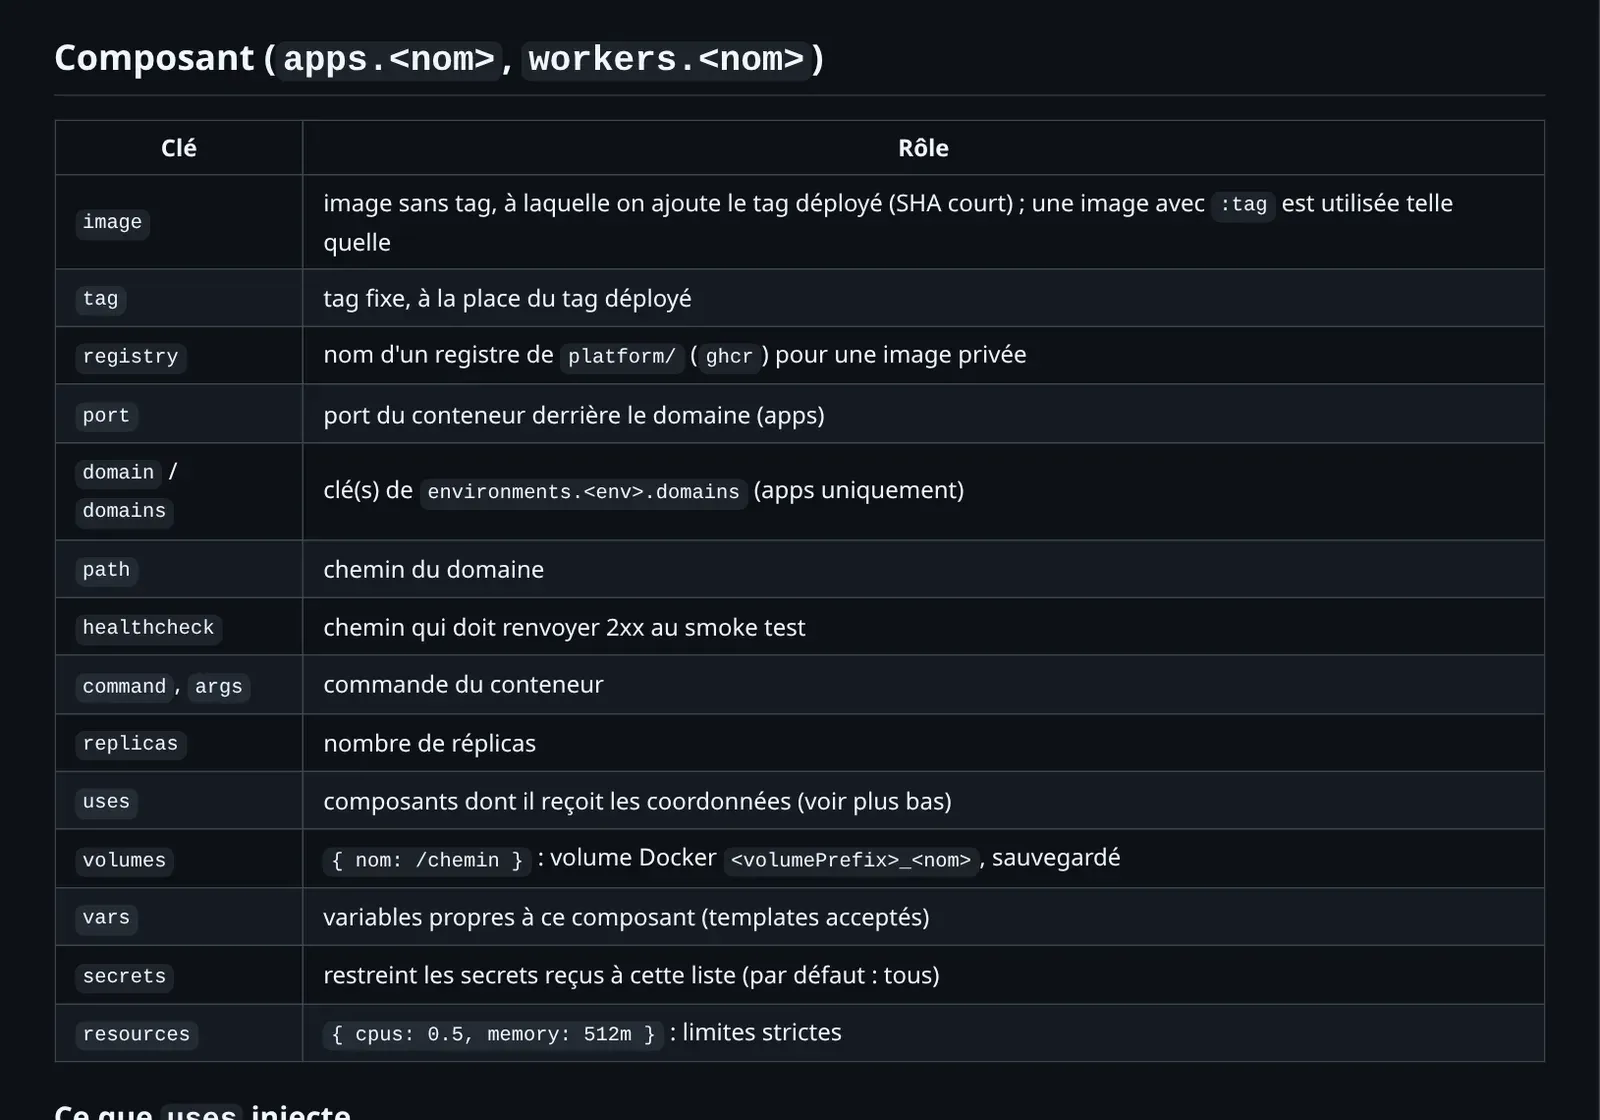
Le fichier est validé par un schéma JSON publié dans le repo. Une ligne en tête du manifest suffit pour avoir la complétion dans l’éditeur.
Ce que le fichier devient
Chaque entrée devient un ou plusieurs objets Dokploy. Une app avec un domain donne une application, un domaine HTTPS avec Let’s Encrypt et un enregistrement A. Un volumes donne un montage et une sauvegarde quotidienne. Une base donne un service Postgres et sa sauvegarde. Rien de tout cela n’est à configurer : les sauvegardes sont actives par défaut, et les désactiver demande une raison écrite que le schéma exige.
Pour le montrer, j’ai rejoué le plan du staging de ce site dans une copie du module, avec le provider simulé des tests. Aucune connexion à Dokploy n’est faite :
On retrouve les quatre composants du manifest, plus une ressource discrète, locked_secrets, sur laquelle je reviens plus bas. Le détail des sauvegardes montre les conventions : un préfixe par app et par environnement, la base à 3h, les volumes à 4h, et sept copies gardées en staging contre trente-cinq en production.
Le passage du module qui traduit uses est court. Une base donne six variables, une autre app donne son URL publique :
contains(keys(local.databases), u) ? [
  for line in [
    ["HOST", local.db_hosts[u]],
    ["PORT", tostring(local.default_ports[local.databases[u].type])],
    ["NAME", try(local.databases[u].database, "")],
    ["USER", local.databases[u].user],
    ["PASSWORD", local.db_password[u]],
    ["URL", format("%s://%s:%s@%s:%d/%s", …)],
  ] : "${try(local.databases[u].envPrefix, "DATABASE")}_${line[0]}=${line[1]}"
] : contains(keys(local.components), u) ? [
  # App to app goes through the public domain: an app_name is only
  # known after its own create […]
  "${upper(replace(u, "-", "_"))}_URL=https://${local.domains[local.components[u].domain]}",
] : ["# unknown uses entry: ${u}"]
Le commentaire dit pourquoi une app en appelle une autre par son domaine public : le nom interne d’un service n’est connu qu’après sa création. C’est une limite assumée, notée dans la doc.
Valider avant de planifier
Un manifest faux ne doit jamais arriver jusqu’au plan. Le validateur contrôle d’abord le schéma, puis la cohérence : chaque uses nomme un composant connu, chaque domaine existe dans chaque environnement, chaque base a son secret de mot de passe déclaré.
Le deuxième fichier contient trois erreurs que le schéma seul ne verrait pas. Le troisième est refusé dès le schéma. Le même script tourne en local, dans make test et en première étape de chaque déploiement.
Les règles de déploiement vivent dans le manifest
Au début, les règles de déclenchement étaient dans les workflows de chaque app. Je les ai déplacées dans le manifest : chaque environnement dit sa branche, et s’il se déploie à chaque push (deploy: auto, le défaut) ou seulement à la main (deploy: manual).
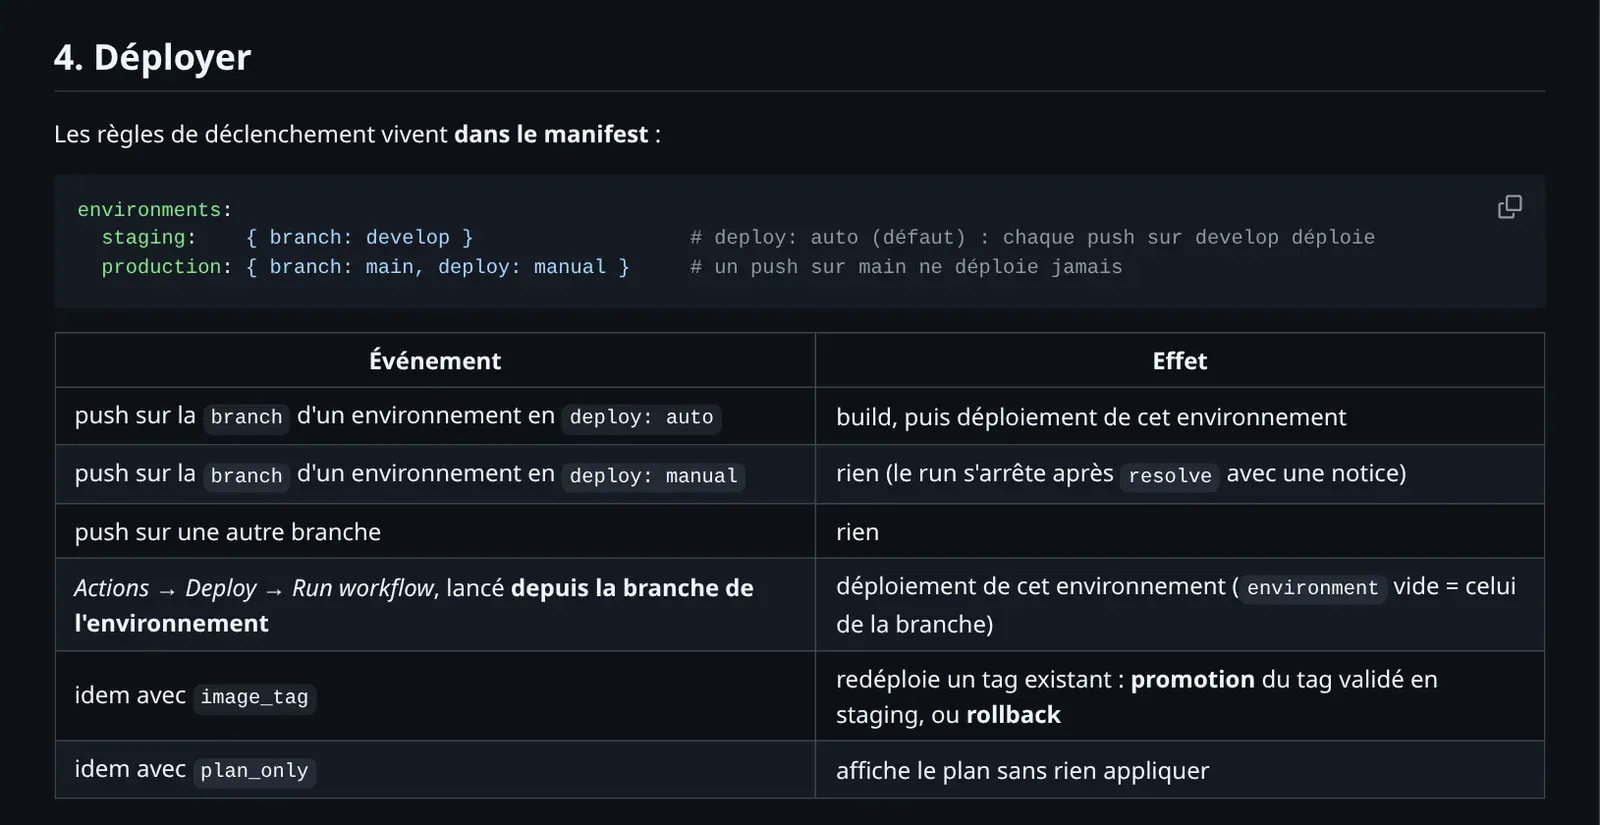
Le workflow de l’app appelle d’abord resolve.yml, qui lit le manifest et répond trois choses : faut-il déployer, vers quel environnement, avec quel tag. Le tag est le SHA court du commit. L’app construit ses images si on le lui demande, puis appelle deploy.yml, qui fait le reste.
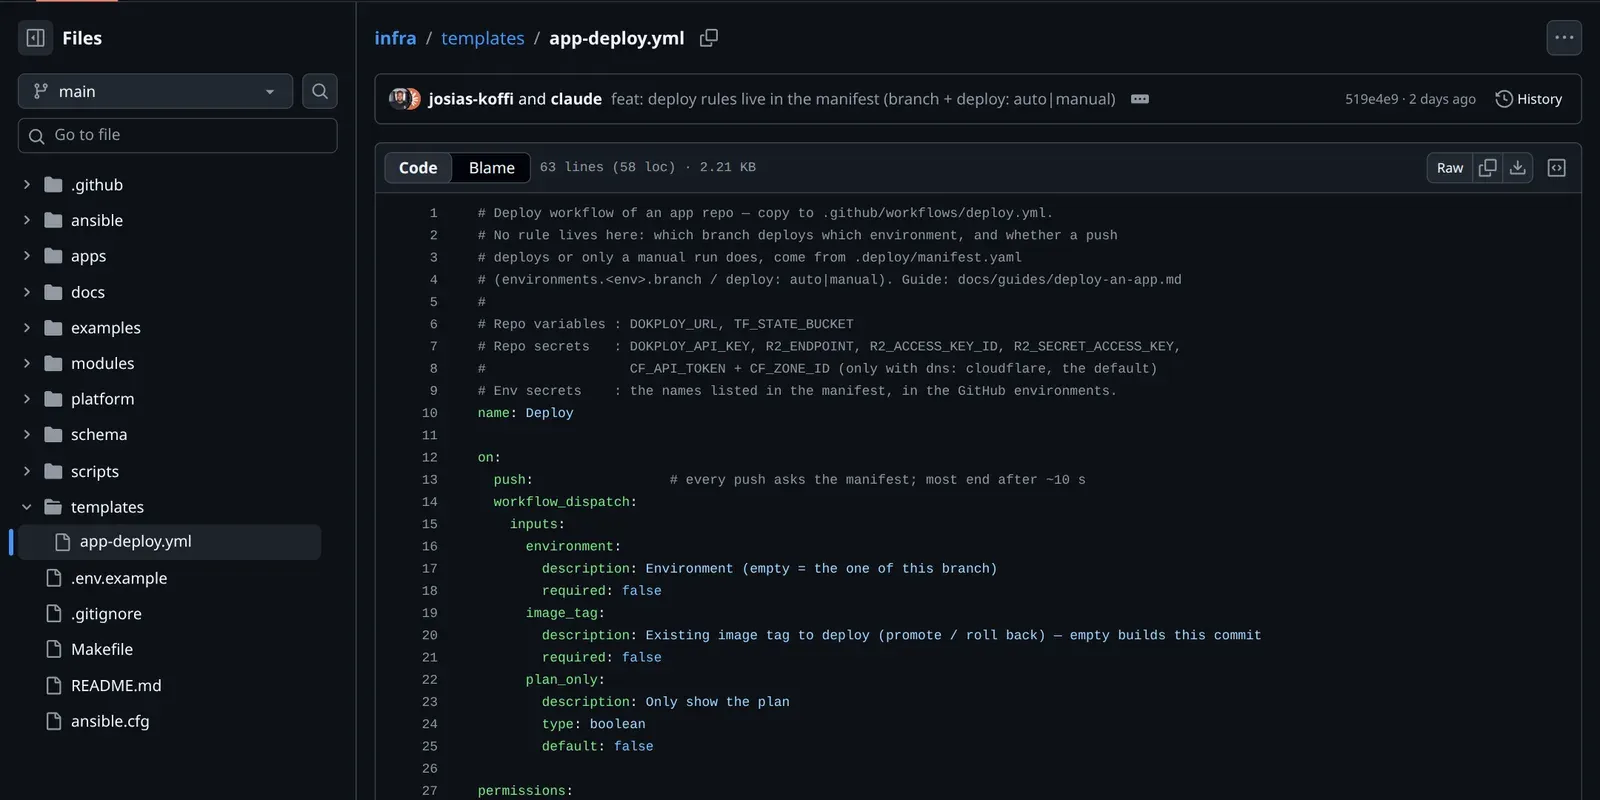
En production, ce site est en deploy: manual. Un push sur main ne fait donc rien d’autre que lire le manifest :
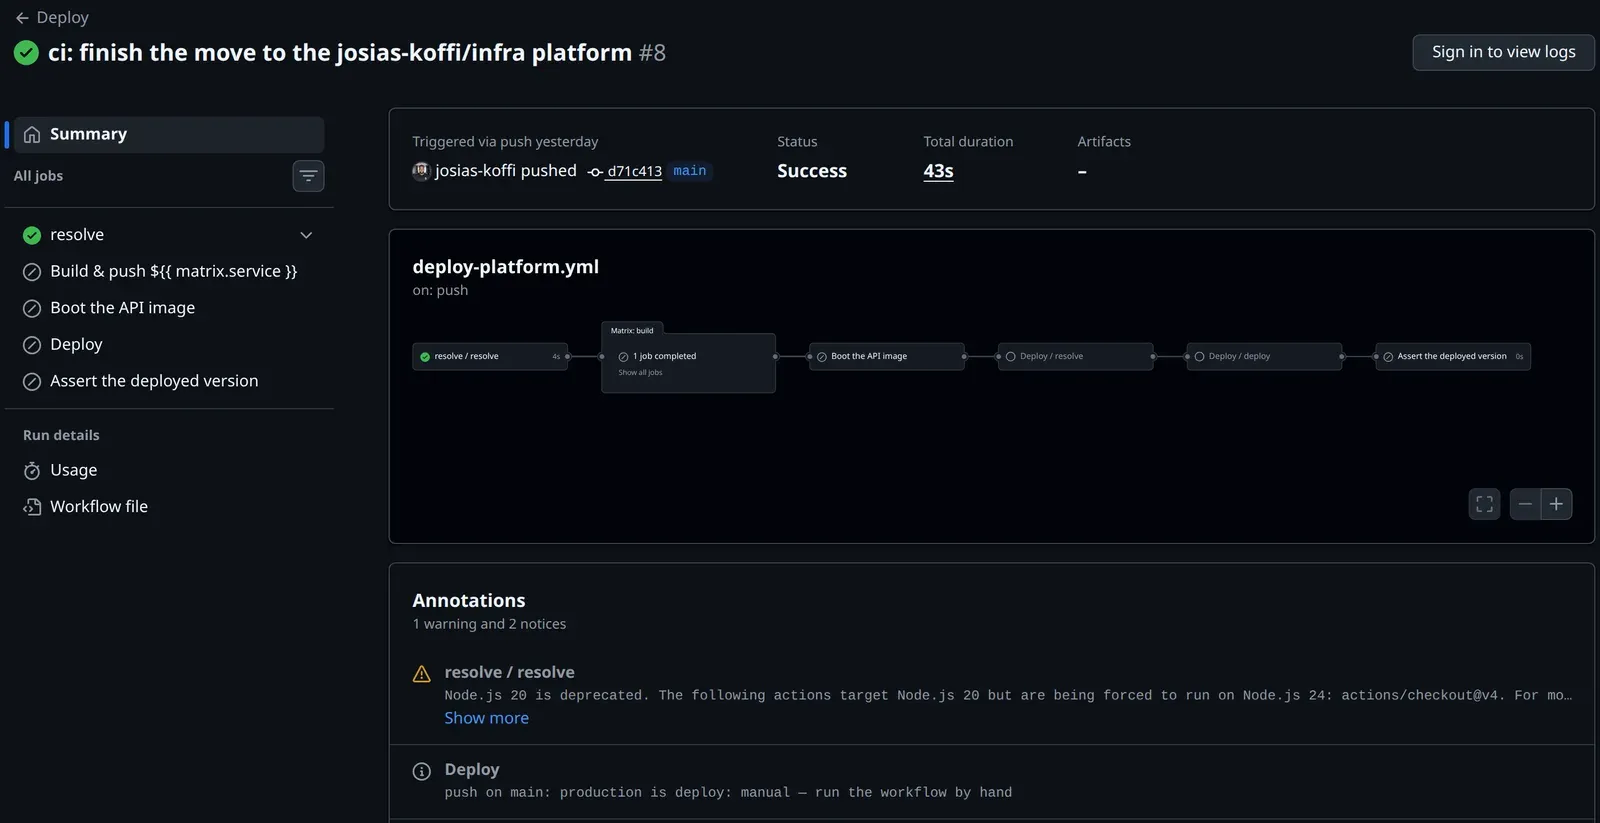
Pour mettre en prod, je relance le workflow depuis main avec le tag qui tourne déjà en staging. C’est une promotion, pas un nouveau build. Le rollback est le même geste avec un tag plus ancien.
Les garde-fous
Un fichier déclaratif a un danger : supprimer une ligne peut supprimer une base. Le script de déploiement enregistre donc le plan, le relit en JSON et refuse deux choses avant l’apply.
- La destruction d’une ressource avec état : une base, un cache, un compose ou un montage. Retirer un environnement passe par un workflow
purge-envprotégé, qui archive les volumes d’abord. - Le changement d’un secret verrouillé. Postgres ne lit son mot de passe qu’à la création du volume. Changer
DB_PASSWORDensuite met à jour la variable, pas le rôle, et l’app ne se connecte plus. Le state garde l’empreinte SHA-256 de chaque secret verrouillé, et un plan qui la change est refusé. C’est la ressourcelocked_secretsdu plan plus haut.
Sur ce site, PAYLOAD_SECRET est verrouillé parce qu’il signe les sessions et l’index des clés API, et les clés root de MinIO parce que MinIO chiffre sa configuration avec. Une rotation volontaire reste possible, nom par nom, avec ALLOW_SECRET_CHANGE.
Reprendre l’existant
Le plus délicat n’a pas été d’écrire le module, mais de reprendre des stacks en production sans rien casser. Avant de toucher quoi que ce soit, j’ai fait des dumps des quatre bases avec leurs comptes de lignes, et je les ai copiés hors du serveur.
Puis j’ai vérifié le comportement de Dokploy sur un projet jetable. Changer l’environnement d’un compose le déplace sur place, sans même redémarrer le conteneur. En revanche, supprimer un compose supprime ses volumes nommés, sauf s’ils sont déclarés external.
Les anciens states ont été libérés avec tofu state rm, jamais destroy. Les sauvegardes R2 existantes ont été importées telles quelles, avec leur arborescence historique, pour ne pas perdre l’historique.
Et le jour où le serveur tombe
Tout cela n’a de sens que si l’on peut repartir de zéro. La procédure est écrite dans le guide des sauvegardes, et elle ne demande rien qui ne soit dans le repo ou dans R2.
- Un nouveau serveur : son IP dans l’inventaire Ansible, dans
platform/nodes.yamlet dans le DNS du panel. make setup-managerinstalle Docker et Dokploy, à la version figée. Le rôle refuse de réinstaller un Dokploy qui tourne.- Dokploy se restaure depuis sa propre sauvegarde quotidienne dans R2 : sa base et
/etc/dokploy. make platform-apply, puis le workflow de chaque app, staging d’abord : les services sont recréés depuis les manifests.- Les bases et les volumes se restaurent depuis R2. Le DNS suit tout seul, puisque les enregistrements A pointent vers l’IP du serveur déclaré.
Le même fichier nodes.yaml sert à ajouter une machine. Un second serveur se prépare avec un playbook, se déclare en une ligne, et une app le choisit avec server:. Il garde son propre Traefik, et Dokploy le pilote en SSH.
Ce que ça change au quotidien
- Le staging se déploie à chaque push sur
develop, la production d’un clic, avec un tag déjà testé. - Chaque base et chaque volume est sauvegardé tous les jours vers R2, dans un bucket par environnement : le staging n’a pas accès aux sauvegardes de prod.
- Un state par environnement : un apply de staging ne peut ni lire ni modifier la prod.
- Un serveur perdu se reconstruit depuis le repo et les sauvegardes, selon une procédure écrite dans la doc.
- Une nouvelle app, c’est un manifest, un workflow copié et ses secrets dans les environnements GitHub.
Il reste des limites. Il n’y a pas de réseau entre serveurs, donc une app et ses dépendances vivent sur la même machine. Les preview deployments par PR ne sont pas encore modélisés. Mais la question « comment cette app est-elle déployée ? » a maintenant une seule réponse, et elle tient dans un fichier que je relis en revue de code comme le reste.
#dokploy#terraform#opentofu#iac#github-actions#backups#cloudflare