D’un cahier des charges à un repo livré en autonomie par des agents.
- Rôle
- Concepteur et mainteneur
- Période
- 2025 — aujourd’hui
- Contexte
- Outil interne, utilisé sur mes produits
1
commande pour un repo complet
~30
incidents encodés en garde-fous
3
couches : framework, projet, delivery
0
merge sans CI verte
Contexte
Les assistants IA codent vite mais sans cadre : pas de tests, pas de review, pas de traçabilité entre le ticket et la mise en production.
Le défi
Rendre une boucle d’agents fiable sur la durée : reprise après quota épuisé, blocages détectés et relancés, garde-fous de qualité non contournables.
- 01IA
Bootstrap depuis une spec
Un renderer shell + templates génère le code, les tests, la CI (Trivy, commitlint, Release Please, Dependabot), la protection de branche et le Kanban GitHub.
- 02Ops
Boucle de livraison sur VPS
Ticket → dev TDD → PR → review par une session neuve → auto-merge si CI verte. Back-off quand le quota est épuisé, escalade humaine seulement si nécessaire.
- 03IA
Skill packs verrouillés
Règles d’ingénierie composées par agent, langage et domaine, figées à un commit pour des runs reproductibles. Serveur MCP CVE local.
- 04Ops
Pilotage mobile
Sessions tmux + Happy : suivre, mettre en pause et débloquer la boucle depuis le téléphone, notifications push.
Architecture
Stack
- Claude Code
- AOAgents & orchestration
- MCP
- GitHub Actions
- RPRelease Please
- Trivy
- Linux
Résultats
- ✦Utilisé pour livrer mes propres produits
- ✦Une trentaine d’incidents de production encodés en correctifs
- ✦Repris comme base de koklo-cli
Le récit
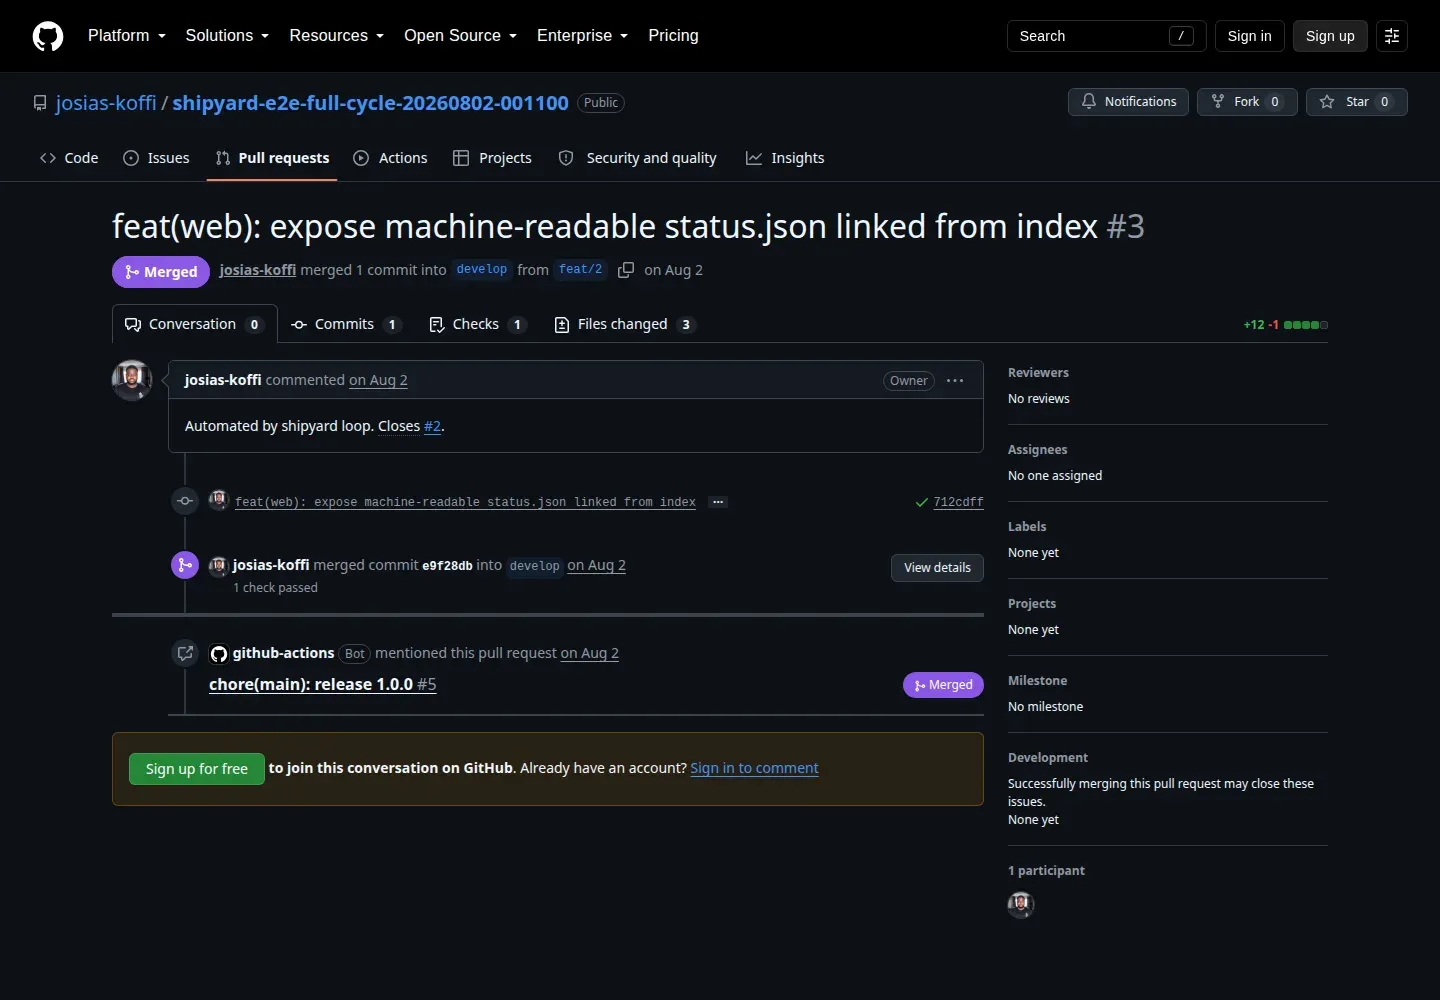
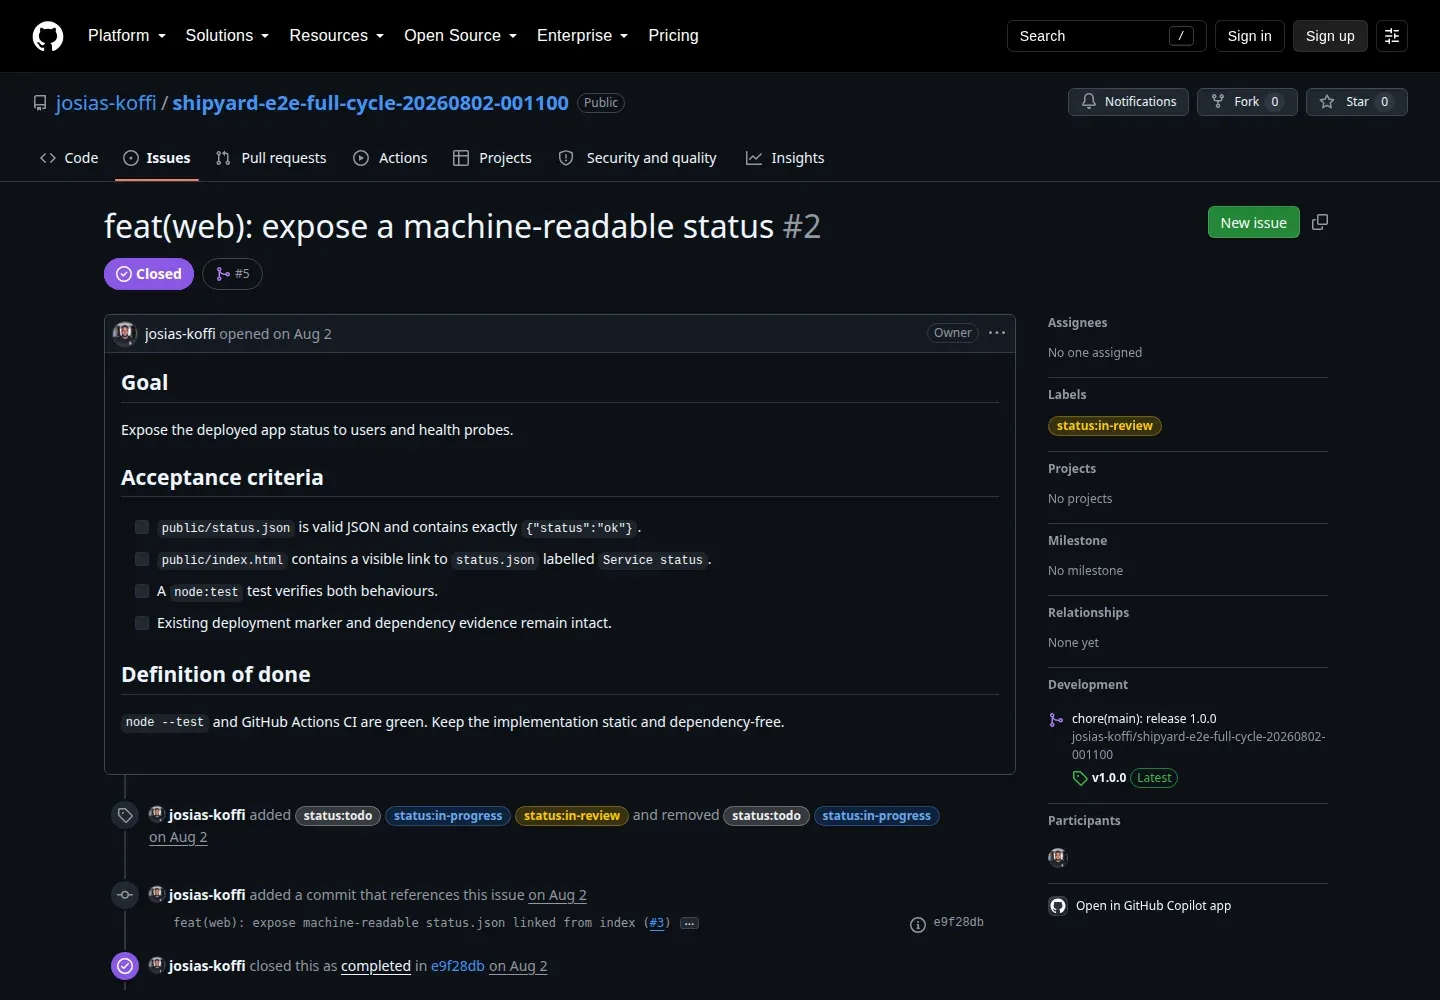
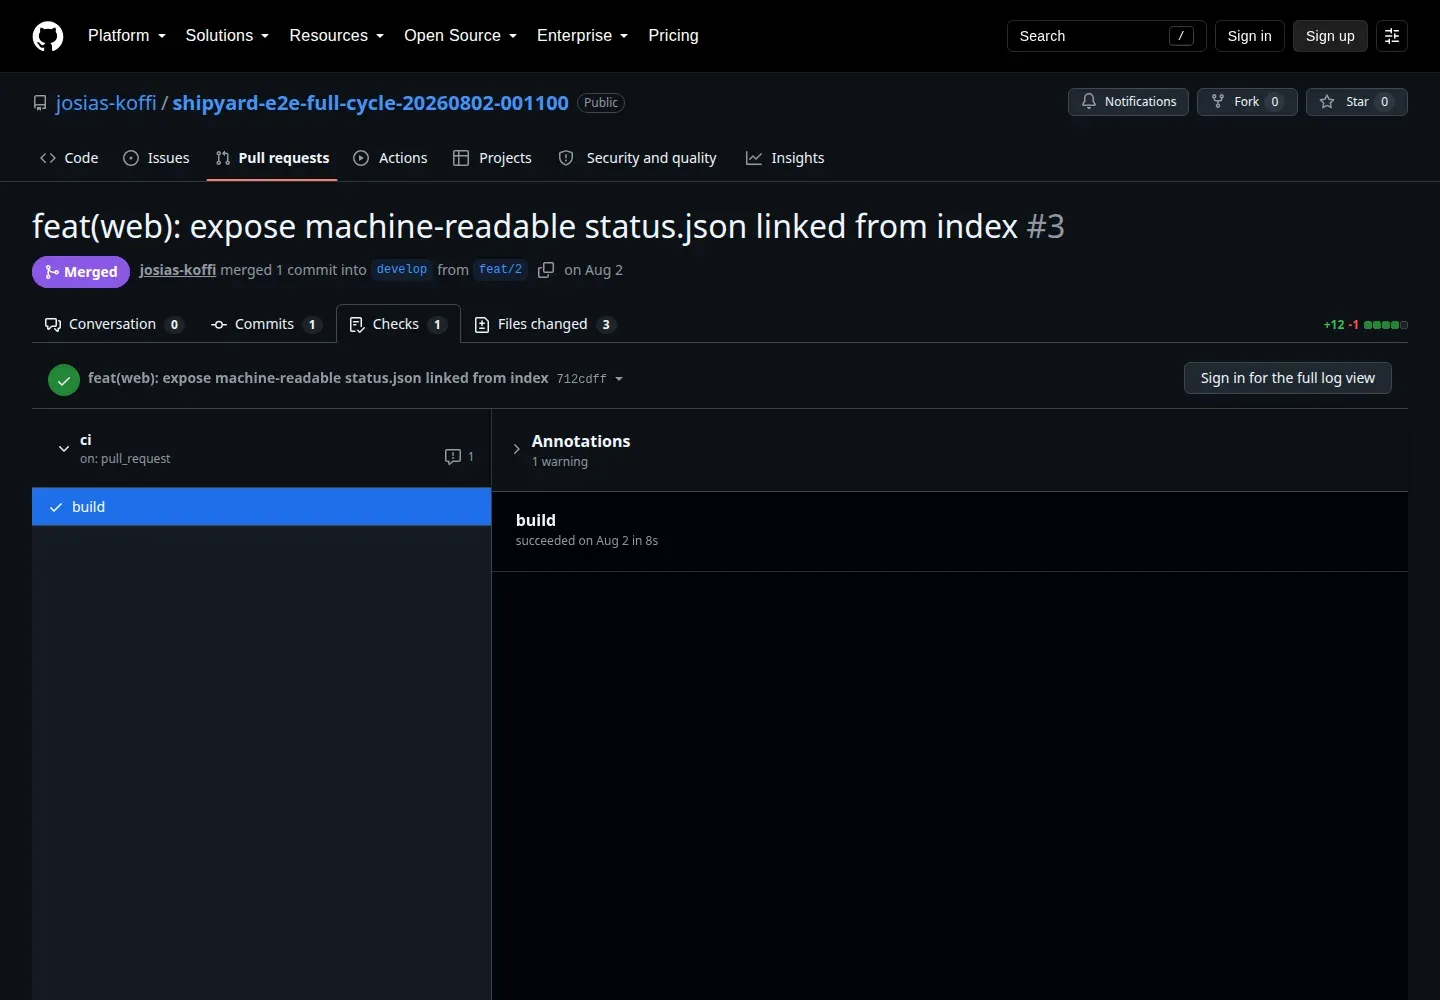
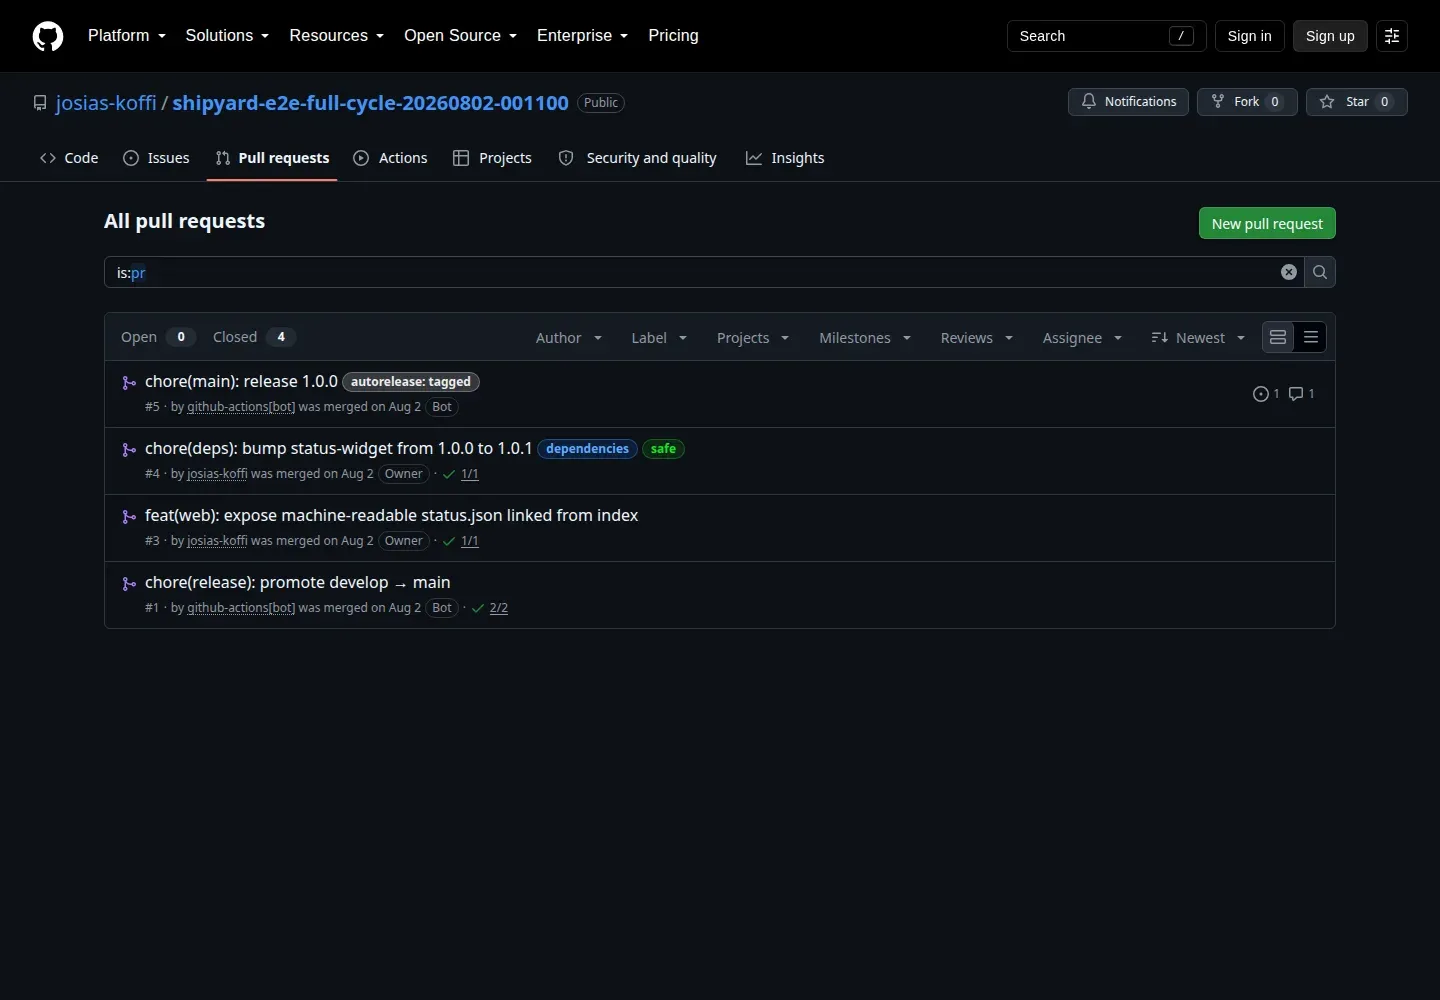
Les captures de cette page viennent de dépôts publics jetables que mes tests de bout en bout créent sur GitHub, par exemple shipyard-e2e-full-cycle. Les issues y sont synthétiques, mais tout le reste est réel : vraies sessions Claude Code, vraie CI GitHub Actions, vrais merges.
Comment ça marche
1. Une issue avec des critères vérifiables
Tout part d’une issue. Le bootstrap la crée depuis le cahier des charges, ou je l’écris à la main. Elle porte un objectif, des critères d’acceptation cochables et une définition de terminé. La session de dev ne reçoit rien d’autre que ce texte, le contexte du projet et les règles d’ingénierie de son rôle.
2. La boucle développe et ouvre la PR
agent-loop.sh prend la prochaine issue « Todo » de l’itération courante, crée un worktree isolé sur feat/<n> et lance une session claude -p neuve sur Sonnet. Le test vient d’abord, puis l’implémentation. Avant tout push, le script rejoue lui-même le lint, les tests et le build du projet. Si un gate est rouge, une session de correction reçoit la commande exacte et la fin de la sortie. Ensuite il commit en Conventional Commits, pousse et ouvre la PR. L’issue passe « In Review ». La phase dev n’attend pas la CI : elle enchaîne sur l’issue suivante.
3. Le gate dur, puis le jugement
La phase review reprend chaque issue « In Review ». Elle attend d’abord que les checks requis soient enregistrés puis terminés. Une CI rouge devient directement un retour de correction, avec le nom du job en échec et la fin de son log. Le reviewer n’est appelé que sur une CI verte, dans une session Opus fraîche qui n’a jamais vu le code s’écrire.
4. Merge, release, promotion
Sur approve, le script merge en rebase sous un verrou global, ferme l’issue, met à jour le board et le vault, puis notifie le téléphone. Dans le test complet, le même dépôt enchaîne ensuite une montée de dépendance, la promotion vers main et la release de Release Please. La PR de dépendance y est simulée par le compte de test, car GitHub ne laisse pas un test se faire passer pour Dependabot.
5. Quand il faut un humain
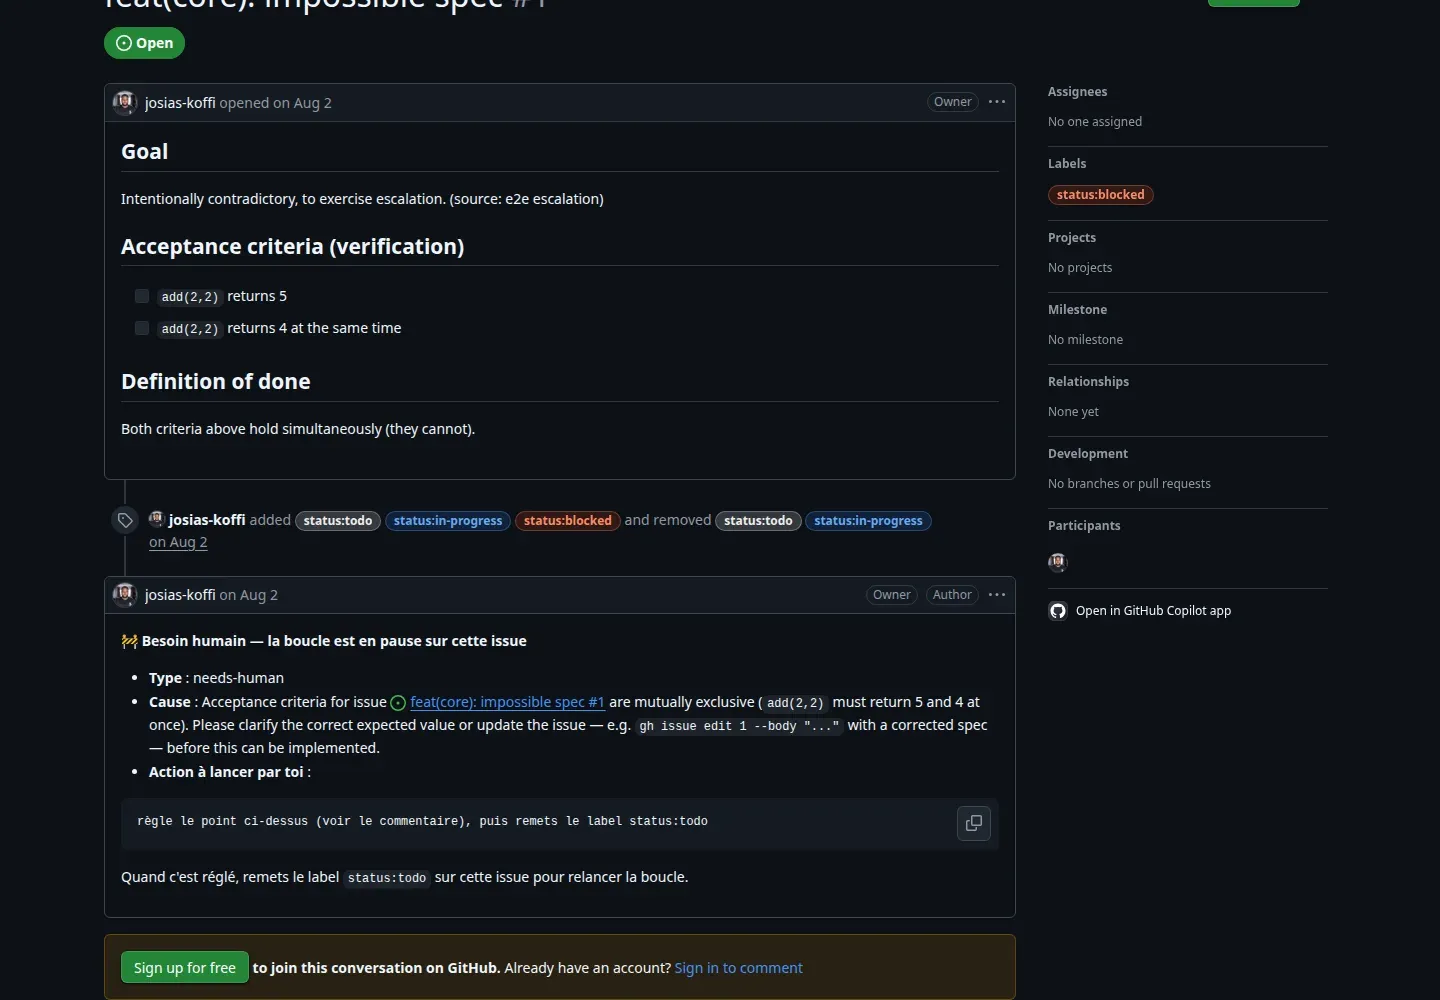
Une issue aux critères contradictoires ne doit pas produire du code. La session de dev renvoie NEEDS-HUMAN:, la boucle passe l’issue en « Blocked » et poste un seul commentaire : la cause, et ce qu’il faut faire pour relancer. Au run suivant, une phase de triage relit chaque blocage contre l’état réel du dépôt. Ce qui n’était bloqué que techniquement repart dans la file.
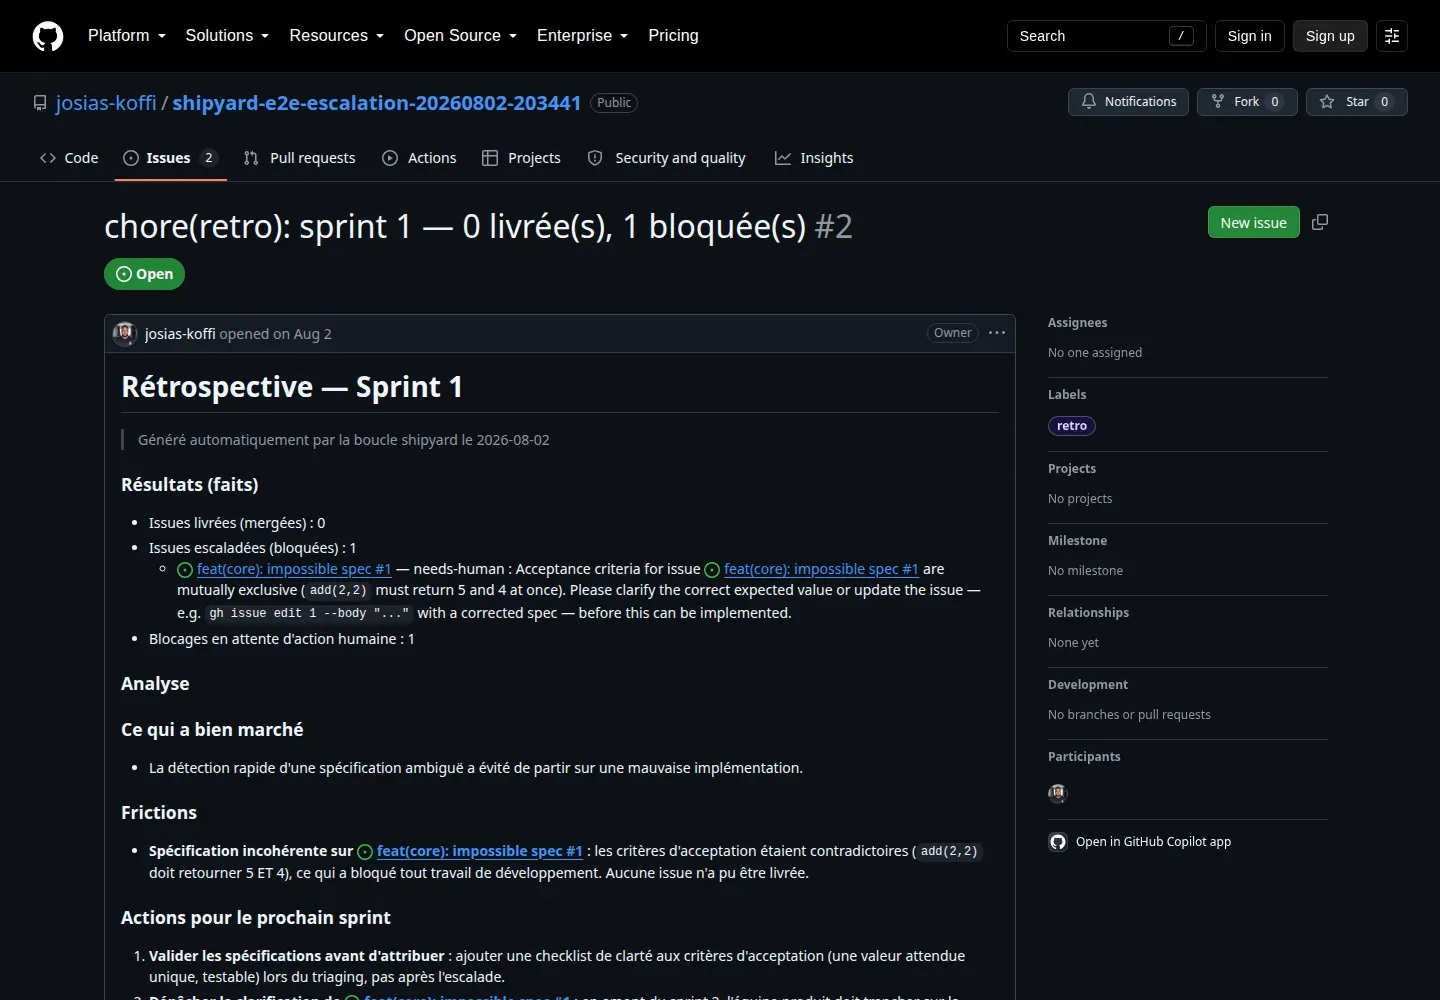
En fin de sprint, une rétrospective est ouverte en issue, faits d’abord.
Sous le capot
Le modèle ne décide jamais de la suite. Le flux de contrôle est un script bash de 2 800 lignes. Chaque agent exécute une étape bornée, dans une session neuve, et rend une sortie que le script analyse : COMMIT:, NEEDS-HUMAN:, VERDICT:. La progression vit dans git, dans le board GitHub et dans state.json, jamais dans le contexte d’un modèle.
On lit le diagramme de gauche à droite. Chaque flèche correspond à un changement de statut écrit par le script, jamais par l’agent. Les boucles sont toutes bornées : 3 tentatives de dev par défaut, 4 tours de review, 2 réintégrations de la base en cas de conflit. Au-delà, l’issue passe « Bloquée ». Le retour depuis « Bloquée » est le travail de la phase de triage. Une session Opus y juge le blocage, et le script applique sa décision. Pour cette session, gh est retiré au niveau du CLI avec --disallowedTools.
while [ "$round" -le "$MAX_REVIEW" ]; do
    round=$((round + 1))
    _review_state_set "$n" "$round" "$conflict_fixes"

    # Hard gate: objective signals. Waits for checks to register + complete.
    local ci_rc=0
    ci_is_green "$pr" || ci_rc=$?
    # … rc 2 = timeout : on réattend sans consommer de tour
    if [ "$ci_rc" -ne 0 ]; then
        verdict="request-changes"
        review_out="$(ci_failure_report "$pr")"
    else
        review_prompt="$(render_prompt "$LOOP_DIR/prompt-review.md" "$review_ctx" qa-reviewer)"
        review_out="$(claude_invoke "$SHIPYARD_REVIEW_MODEL" "$review_prompt")" || break
        verdict="$(grep -m1 '^VERDICT:' <<<"$review_out" | sed 's/^VERDICT:[[:space:]]*//')"
    fi

    [ "$verdict" = "approve" ] || post_review_comment "$pr" "$round" "$MAX_REVIEW" "$verdict" "$review_out"

    if [ "$verdict" = "approve" ]; then
        _with_lock "$REPO_ROOT/.project/.merge.lock" merge_pr "$pr" || { …; }
        finalize_merged_issue "$n" "$pr" "$SHIPYARD_REVIEW_LABEL" "$round"
        return 0
    fi
    # sinon : session de correction (Sonnet) avec le retour réinjecté, push, tour suivant
done
C’est le cœur du gate de merge. La CI est consultée avant le reviewer, et un verdict qui n’est pas approve est publié en commentaire sur la PR. Les verdicts restent ainsi lisibles après coup. Le merge passe par un verrou, parce que deux PR qui mergeaient en même temps se battaient sur « base out of date ».
Ce que la machine dit d’elle-même
Le diagnostic de l’hôte, lancé sur ma machine :
Le test de fumée de la boucle simule gh et claude, mais pousse vers un vrai remote git local. Il rejoue 29 scénarios en une minute, sans quota. Le jour où je l’ai lancé pour cette page, il rendait 170 vérifications vertes et une rouge : la passe de doc de la boucle heurtait encore le contrôle de périmètre monorepo dans un scénario. Je le laisse tel quel.
D’où ça vient, où ça va
shipyard reprend le socle d’agent-setup : renderer shell, templates, rôles TDD et state.json. Il abandonne Codex pour se concentrer sur Claude Code, et ajoute la boucle autonome. koklo-cli reprend ensuite la boucle et surtout l’ordre de ses gardes, mais la réécrit en Rust sur une base SQLite unique.
Ce que j’en retiens
- Le script décide, l’agent exécute. Le modèle ne choisit jamais l’étape suivante. Un échec devient alors un état du script, qu’on peut rejouer dans un test de fumée, et non une décision qu’il faut deviner après coup.
- Chaque incident devient un garde-fou, et un test. Un timeout de CI compté comme un échec, un dernier correctif jamais relu avant l’escalade, un budget de review remis à neuf à chaque reprise : une trentaine de cas sont encodés dans le code, avec leur commentaire et leur scénario de fumée.
- Trois sources de vérité, c’est deux de trop.
state.json, les labels GitHub et le board se désynchronisaient. Une issue dont le travail était déjà poussé est ainsi revenue en dev, a produit un diff vide, puis a été escaladée, en boucle. C’est la raison principale de la réécriture dans koklo-cli.
Galerie
Parlons-en. Décrivez votre besoin en quelques lignes, je reviens vers vous sous 48 h.